A quoi sert un factor ?
Un factor est un type spécifique de vecteur qu’on trouve dans R, à côté de types plus connus comme les entiers (integer), les réels (double parfois vus comme numeric même si, stricto sensu, le type numeric regroupe à la fois les types integer et double), les textes (character), etc. Visuellement il est semblable à un vecteur texte. Mais son mode de stockage est différent.
- Un factor permet de gagner de la place : quand une valeur texte est répétée un grand nombre de fois dans un vecteur, le stockage sous forme de factor est bien plus économique que sous forme de texte.
set.seed(123) genres <- sample(c("Femme","Homme"), 10000, replace = TRUE) object.size(genres) # type character80160 bytesobject.size(as.factor(genres)) # type factor40560 bytes
- Un factor permet de spécifier un ordre de ses valeurs autre qu’alphabétique dans un tableau ou un graphique, ainsi que pour définir la modalité de référence dans un modèle statistique.
- Un factor permet de faire apparaître dans un tableau ou un graphique une catégorie, qu’elle soit présente ou non dans les données.
Des exemples concrets d’utilisation d’un factor sont en fin de cet article (Cas d’usage d’un factor).
Quel est le secret du factor ?
Le mode de stockage spécifique au factor est composé de deux parties : un vecteur d’entiers et un dictionnaire. Le dictionnaire permet de faire la correspondance entre un entier et un libellé. A l’affichage du factor, on ne voit jamais les entiers, uniquement les libellés.
Les entiers sont attribués arbitrairement à la création du factor ou lors de certaines opérations qui le modifient (voir plus bas). Par défaut, ils sont associés aux valeurs du vecteur (libellés) par ordre alphabétique. On peut voir le dictionnaire avec la fonction levels : les libellés sont affichés, les entiers peuvent se déduire de leur position. Au premier libellé correspond l’entier 1, au 2e libellé, l’entier 2, etc.
niveaux <- c("CP", "CE1", "CE2", "CM1", "CM2") |>
              as.factor()
levels(niveaux)
[1] "CE1" "CE2" "CM1" "CM2" "CP" Comme on le constate ci-dessus, l’attribution des entiers par ordre alphabétique n’est pas toujours pertinente. Si on veut conserver l’ordre dans lequel les élèves avancent dans les niveaux de l’école primaire, on devra utiliser la fonction factor plutôt que as.factor car elle est plus riche d’options. Ici, c’est l’option levels qui nous intéresse : elle indique comment constituer le dictionnaire.
niveaux <- c("CP", "CE1", "CE2", "CM1", "CM2")
niveaux_fct <- factor(niveaux, levels=niveaux)

levels(niveaux_fct)
[1] "CP" "CE1" "CE2" "CM1" "CM2"⚠️ Attention ! L’option levels n’est absolument pas discutée par R et encore moins confrontée aux données. S’il est indiqué dans levels une valeur absente des données, elle sera quand même prévue dans le dictionnaire (ce qui est souvent une bonne chose) ; si une valeur présente dans les données n’est pas citée dans levels alors le factor contiendra un NA à la place de la valeur “imprévue” (ce qui peut être un problème quand ce n’est pas l’intention de l’auteur du code).
pays <- c("France", "Allemagne", "Italie", "Espagne")
# avec un pays en plus dans le dictionnaire
pays_fct <- factor(pays, levels=c("Espagne","Italie",
                                  "Suisse","Allemagne",
                                  "France"))

pays_fct          # équivalent à pays, on voit la Suisse dans le dictionnaire
[1] France Allemagne Italie Espagne
Levels: Espagne Italie Suisse Allemagne France# avec une coquille dans le dictionnaire ("e" manquant à Italie)
pays_fct <- factor(pays, levels=c("Espagne","Itali",
"Allemagne","France"))
pays_fct # NA à la place d'Italie, l'Italie mal orthographiée est dans le dictionnaire[1] France Allemagne <NA> Espagne
Levels: Espagne Itali Allemagne FranceCréer un factor
On a vu dans les exemples ci-dessus que deux fonctions du package {base}, as.factor et factor, permettaient de créer des factors.
Ajoutons la fonction forcats::as_factor qui a une manière légèrement différente d’attribuer les entiers dans la constitution du dictionnaire : au lieu de suivre l’ordre alphabétique des modalités, as_factor utilise l’ordre d’apparition des modalités dans le vecteur à convertir.
Dans l’immense majorité des cas le vecteur à convertir est de type caractère. Il est bien sûr possible de convertir des nombres en factor ; mais dans ce cas l’opération réciproque est un peu plus complexe.
# vecteur texte : la conversion texte <-> factor est aisée
c("b","a","c") |> as.factor()
[1] b a c
Levels: a b cc("b","a","c") |> as.factor() |> as.character()[1] "b" "a" "c"# vecteur numérique : la conversion factor -> numérique comporte un piège
c(33,11,12) |> as.factor()[1] 33 11 12
Levels: 11 12 33c(33,11,12) |> as.factor() |> as.numeric()[1] 3 1 2# il faut passer par un vecteur caractère !
c(33,11,12) |> as.factor() |> as.character() |> as.numeric()[1] 33 11 12Par rapport à base::as.factor et forcats::as_factor, la fonction base::factor offre des options très intéressantes, dont levels déjà évoquée. En particulier l’option labels permet de stocker dans le dictionnaire du factor des valeurs différentes de celles présentes dans le vecteur d’origine. Cependant, il ne s’agit pas d’un second niveau de dictionnaire : on ne peut pas, le factor créé, revenir aux valeurs initiales.
L’option labels est constituée d’un vecteur texte de même longueur que celui de levels. S’opère alors une transcription dans le sens valeur de levels -> valeur de labels, et le dictionnaire sera construit avec les labels.
pays <- c("fr","de","it","es")
pays_fct <- factor(pays,
                   levels=c("es","it","de","fr"),
                   labels=c("Espagne","Italie","Allemagne",'France'))
pays_fct
[1] France Allemagne Italie Espagne
Levels: Espagne Italie Allemagne FranceModifier l’ordre du dictionnaire
On l’a dit, au-delà du gain de place procuré par un factor, sa principale utilité est de pouvoir indiquer un ordre sur mesure dans un tableau, un graphique ou un modèle statistique. Cet ordre peut être défini dès la création du factor, avec l’option levels de factor ou avec l’ordre par défaut (alphabétique dans as.factor et factor, d’apparition dans le vecteur d’origine dans forcats::as_factor). Mais il peut également être modifié a posteriori.
Pour cela, le package {forcats} est d’une grande utilité, car il simplifie nombre de manipulations sur l’ordre du dictionnaire avec les fonctions suivantes.
fct_rev: on renverse l’ordre du dictionnaire. La dernière valeur devient la première, l’avant-dernière entrée du dictionnaire devient la deuxième, etc. Par exemple si l’ordre initial d’un factorfacétaita b c d, alorsfct_rev(fac)renvoie un factor dont l’ordre serad c b a.library(forcats) # exemple sur les taux de chaque mention du DNB ("Brevet des collèges") 2026 ; source : https://www.education.gouv.fr/depp/diplome-national-du-brevet-2026-session-de-juin-505280, données de la figure 1 pct_admis <- dplyr::tribble( ~ mention, ~ pct, "aucune", 20.3, "assez bien", 24, "bien", 21.1, "très bien",13.3, "très bien avec félicitations du jury",3 ) pct_admis$mention <- as_factor(pct_admis$mention) levels(pct_admis$mention)[1] "aucune" [2] "assez bien" [3] "bien" [4] "très bien" [5] "très bien avec félicitations du jury"# en inversant le dictionnaire levels(fct_rev(pct_admis$mention))[1] "très bien avec félicitations du jury" [2] "très bien" [3] "bien" [4] "assez bien" [5] "aucune"fct_infreq: on reconstruit le dictionnaire en fonction de la fréquence (le nombre d’occurrences) des valeurs du vecteur. Si le vecteurfacvaut"a" "b" "b" "c" "b" "c"alors l’ordre du dictionnaire defct_infreq(fac)serab c a.fct_reorder: l’idée est proche de ce que proposefct_infreq, mais en s’appuyant sur un second vecteur, numérique celui-ci, dont on ordonne les statistiques par valeur du factor. Concrètement, si on a un factorfacet un vecteur numériquenum, alorsfct_reorder(fac, num, stat)va calculer la statistique demandée (une somme, une moyenne, une médiane, un maximum, un minimum, etc. ; on indique ici le nom d’une fonction statistique de R, sans parenthèses) par valeur defac, puis trier le résultat par ordre croissant de la statistique calculée. L’ordre des groupes defacainsi obtenu sera alors l’ordre du nouveau dictionnaire.
Des options commena.rm=TRUEet.desc=TRUEpeuvent s’ajouter, respectivement pour ne pas prendre en compte les valeurs manquantes denumet pour un tri décroissant des groupes.levels(fct_reorder(pct_admis$mention, pct_admis$pct, mean))[1] "très bien avec félicitations du jury" [2] "très bien" [3] "aucune" [4] "bien" [5] "assez bien"# par ordre décroissant levels(fct_reorder(pct_admis$mention, pct_admis$pct, mean, .desc=TRUE))[1] "assez bien" [2] "bien" [3] "aucune" [4] "très bien" [5] "très bien avec félicitations du jury"
Citons aussi la fonction stats::relevel qui permet de déplacer en premier dans l’ordre du dictionnaire une des modalités et de décaler toutes les autres en conséquence. Par exemple si l’ordre initial d’un factor fac était a b c d, alors relevel(fac, "c") renvoie un factor dont l’ordre sera c a b d.
Enfin, un cas très particulier sera illustré ci-dessous : quand on souhaite réordonner un dictionnaire en fonction d’un autre vecteur, comme avec fct_reorder, mais pas de manière globale, à l’intérieur de sous-groupes. Pour cela on utilisera la fonction tidytext::reorder_within. Le cas d’usage classique est d’ordonner un diagramme en bâtons “éclaté” avec la fonction ggpplot2::facet_wrap. Nous le verrons en action ici : Dans un graphique
Cas d’usage d’un factor
Dans un graphique
Pour personnaliser l’ordre des modalités
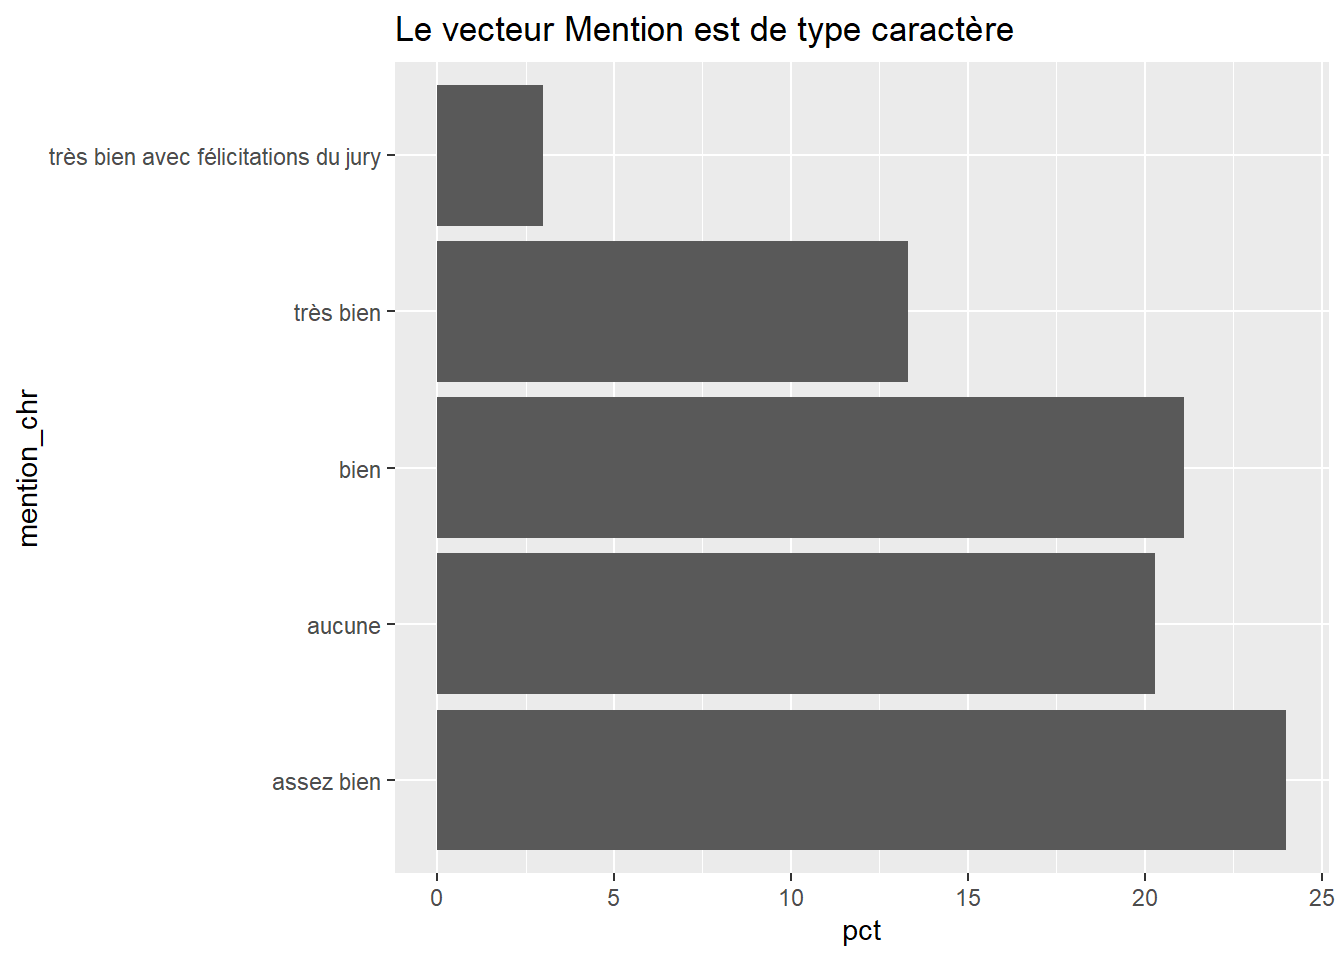
Quand on utilise un vecteur texte dans un graphique, que ce soit pour lui associer un axe ou un attribut visuel (couleur, type de marqueur ou de pointillé, …), le seul ordre possible est l’ordre alphabétique.
Un factor permet de se démarquer de cette contrainte en utilisant un ordre métier, pertinent pour améliorer la lisibilité du graphique.
library(ggplot2)
pct_admis$mention_chr <- as.character(pct_admis$mention)

ggplot(pct_admis) +
  aes(y=mention_chr, x=pct) +
  geom_col() +
  labs(title="Le vecteur Mention est de type caractère")
ggplot(pct_admis) +
  aes(y=mention, x=pct) +
  geom_col() +
  labs(title="Le vecteur Mention est de type factor,\ndans l'ordre d'excellence des mentions")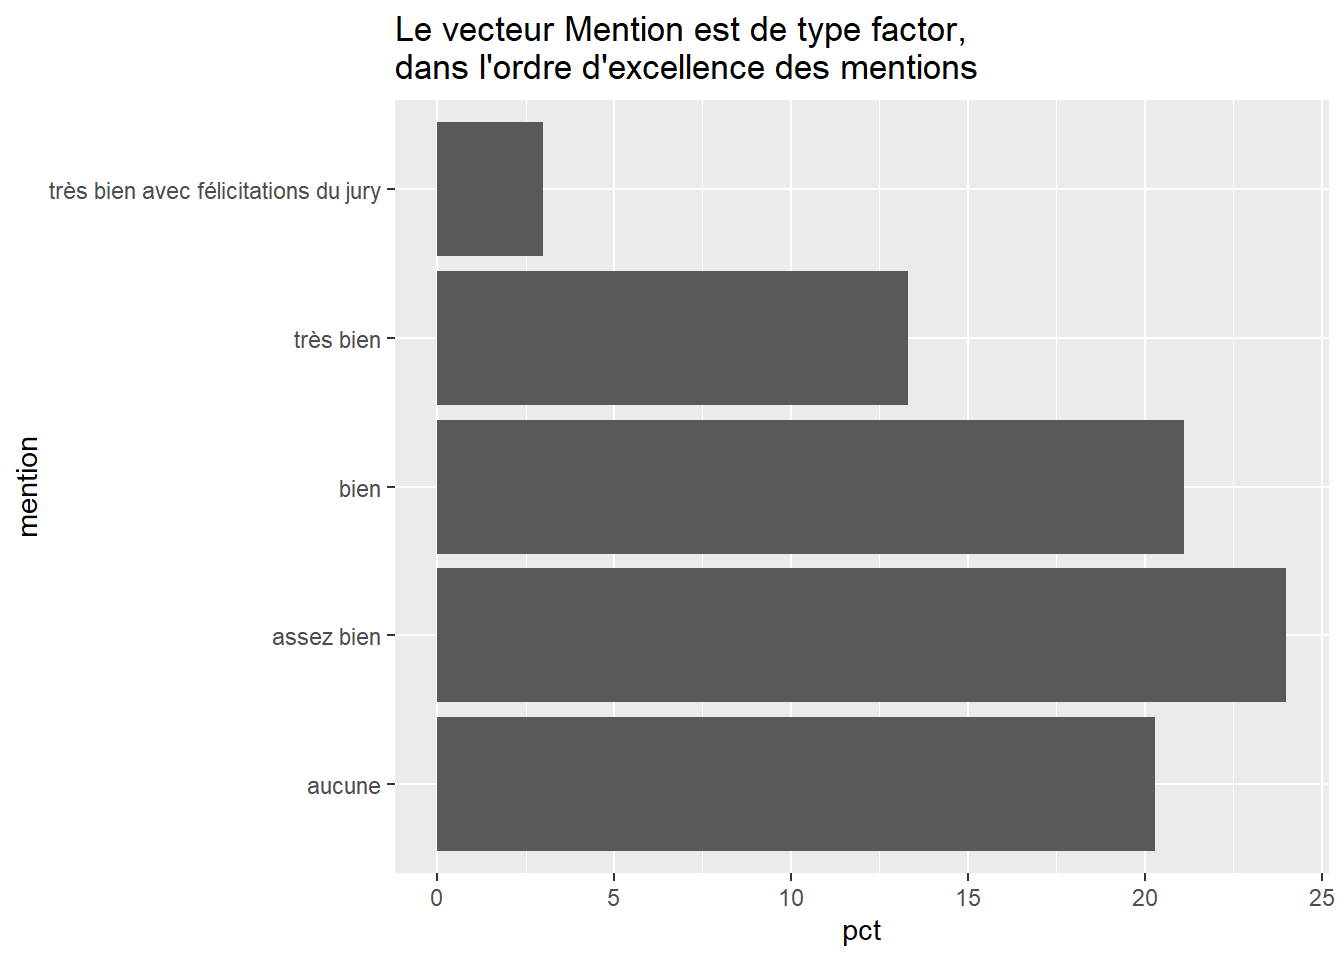
ggplot(pct_admis) +
  aes(y=fct_reorder(mention,
                    pct,
                    mean), x=pct) +
  geom_col() +
  labs(title="Le vecteur Mention est de type factor,\ndans l'ordre de fréquence des mentions")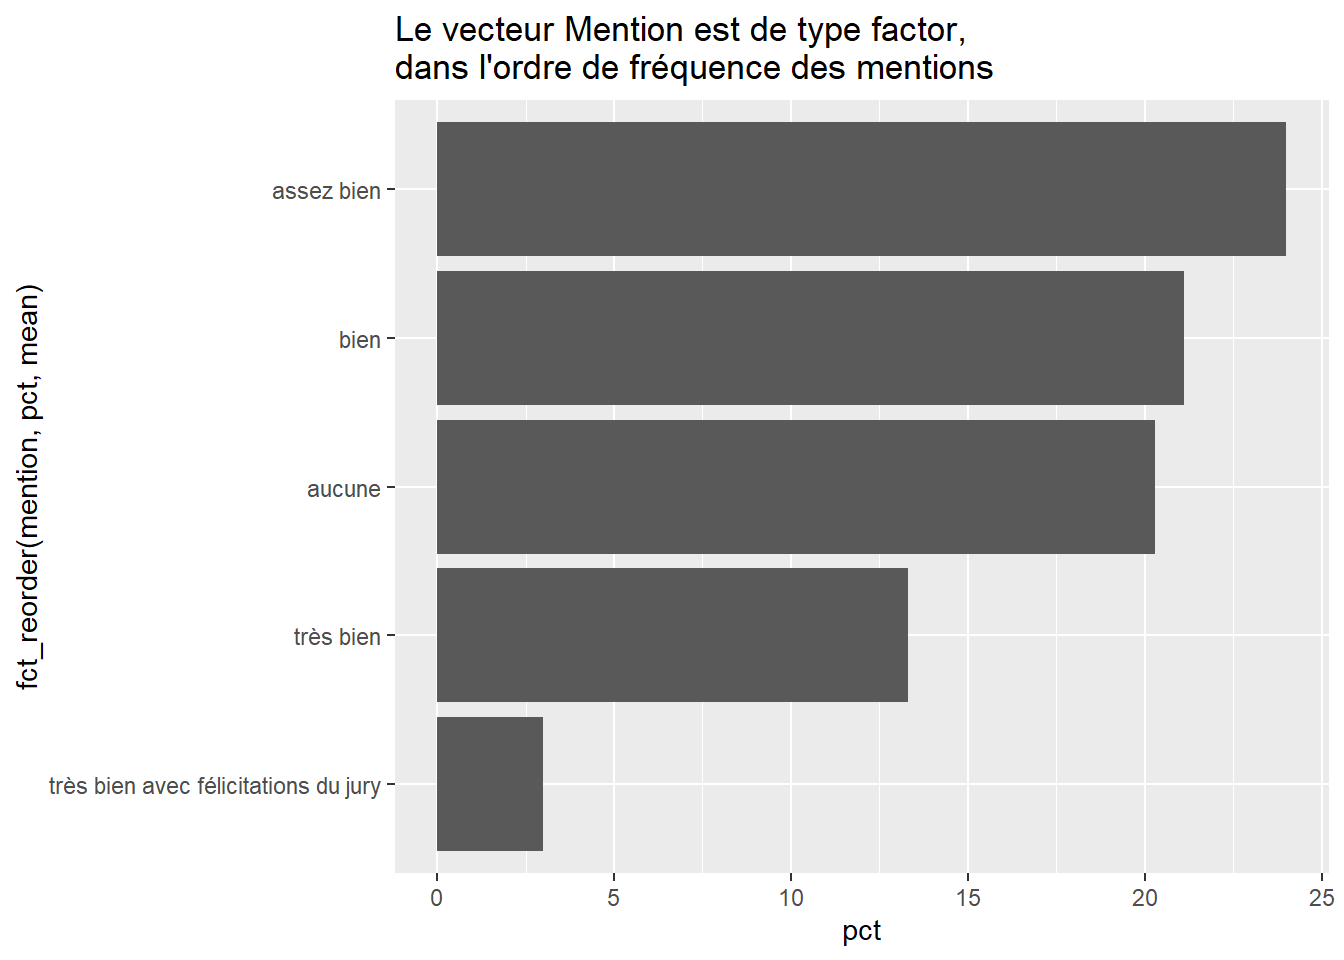
Voyons maintenant le cas où on souhaite représenter les taux de réussite des DNB de série générale et de série professionnelle, par académie.
dnb_acad <- tribble(
  ~acad, ~generale, ~professionnelle,
  'Aix-Marseille',81.7,62.2,
  'Amiens',82.6,62.1,
  'Besançon',85.3,69.6,
  'Bordeaux',86.5,68.2,
  'Clermont-Ferrand',86.2,66.8,
  'Corse',89.1,77.4,
  'Créteil',79.4,55.7,
  'Dijon',83.2,67.5,
  'Grenoble',84.9,70,
  'Guadeloupe',71.5,42.7,
  'Guyane',58.7,44.4,
  'La Réunion',80.8,74.2,
  'Lille',84.1,58.7,
  'Limoges',82.5,67.2,
  'Lyon',86.9,66.4,
  'Martinique',81.3,57.4,
  'Mayotte',64.9,40.8,
  'Montpellier',83.2,68.6,
  'Nancy-Metz',83.2,64.7,
  'Nantes',88,69.6,
  'Nice',82,63.1,
  'Normandie',81.8,67.9,
  'Orléans-Tours',81.8,65.4,
  'Paris',88.6,63.8,
  'Poitiers',85.4,67.2,
  'Reims',79.3,61.6,
  'Rennes',90.3,68,
  'Strasbourg',83.4,68.7,
  'Toulouse',86.1,69.7,
  'Versailles',81.6,55.4
) %>%
  tidyr::pivot_longer(
    cols=-acad,
    names_to = "serie",
    values_to = "tx_reussite")

ggplot(dnb_acad) +
  aes(y=acad,
      x=tx_reussite,
      fill=serie) +
  geom_col(position="dodge") +
  labs(title="Version 1 : académies par ordre alphabétique")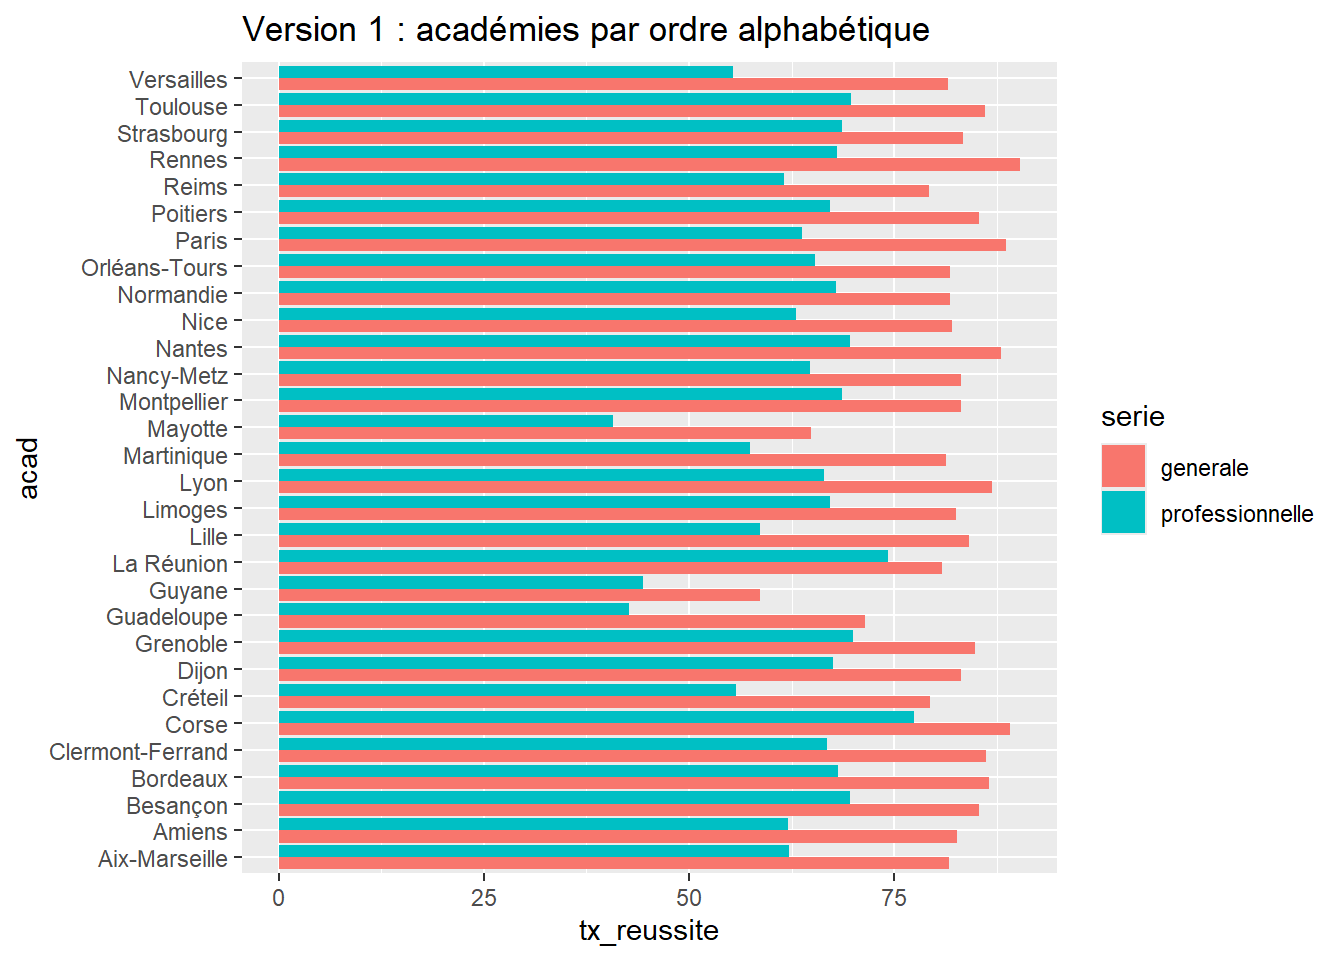
ggplot(dnb_acad) +
  aes(y=fct_reorder(acad, tx_reussite),
      x=tx_reussite,
      fill=serie) +
  geom_col(position="dodge") +
  labs(title="Version 2 : académies par taux moyen de réussite")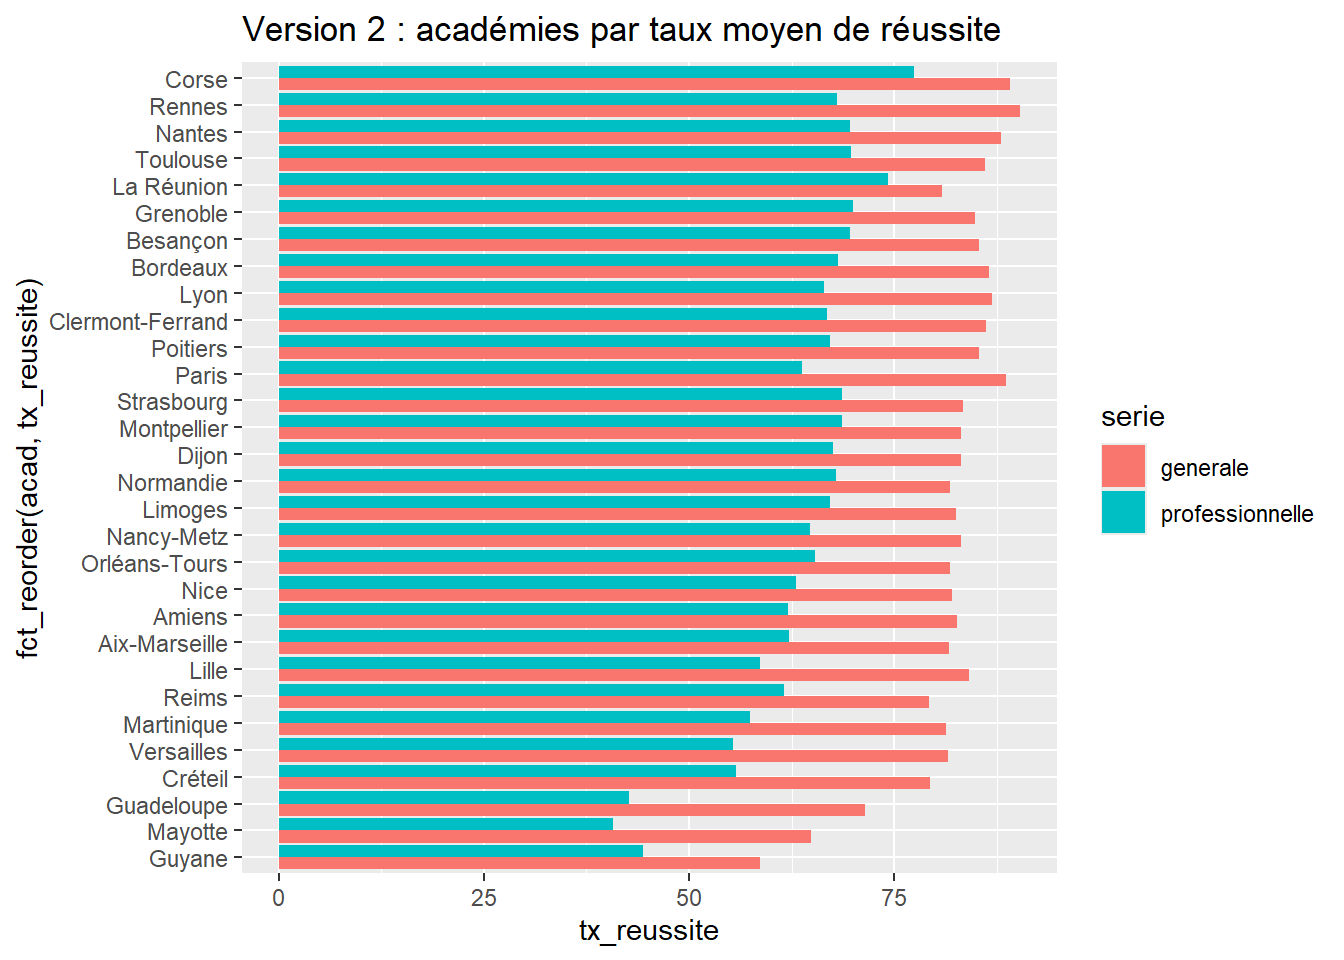
Cette deuxième version n’est pas très satisfaisante, car l’ordre qu’on souhaite associer aux académies ne ressort pas directement sur le graphique. Et si on sépare en 2 graphiques distincts les séries, ce n’est pas forcément plus concluant.
ggplot(dnb_acad) +
  aes(y=fct_reorder(acad, tx_reussite),
      x=tx_reussite,
      fill=serie) +
  geom_col(position="dodge") +
  labs(title="Version 3 : académies par taux moyen de réussite",
       subtitle="avec éclatement par série") +
  facet_wrap(vars(serie))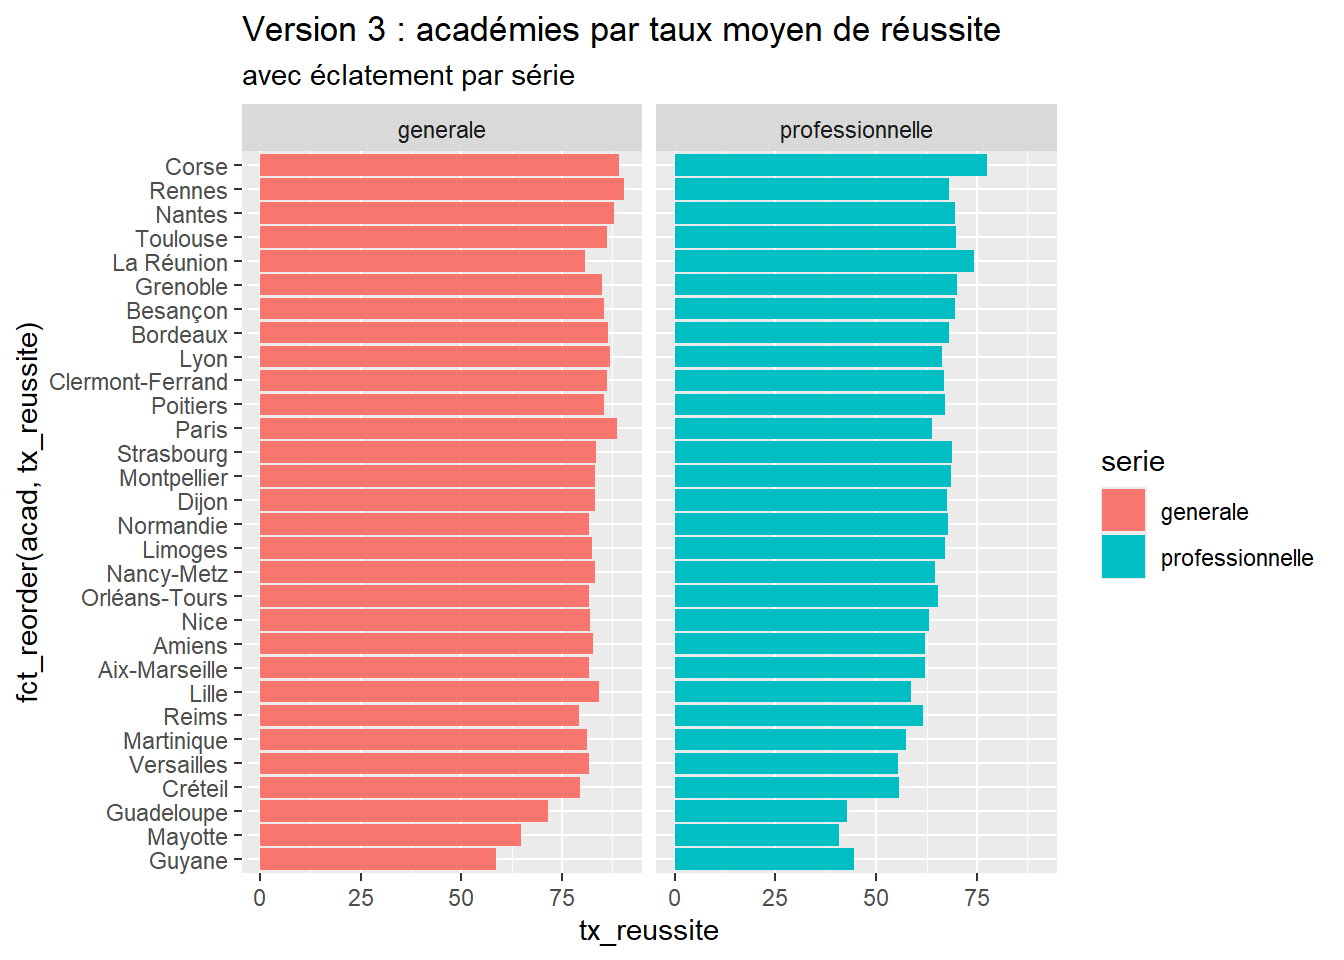
Dans aucune des deux séries, l’ordre des taux de réussite moyens ne coïncide avec l’ordre observé. Le résultat est donc encore médiocre. C’est là qu’intervient la fonction tidytext::reorder_within qui va nous permettre d’ordonner nos académies par taux de réussite à l’intérieur de chaque série, indépendamment.
library(tidytext)
ggplot(dnb_acad) +
  aes(y=reorder_within(acad, tx_reussite, serie),
      x=tx_reussite,
      fill=serie) +
  geom_col(position="dodge") +
  labs(title="Version 4 : académies par taux moyen de réussite",
       subtitle="avec éclatement par série") +
  facet_wrap(vars(serie))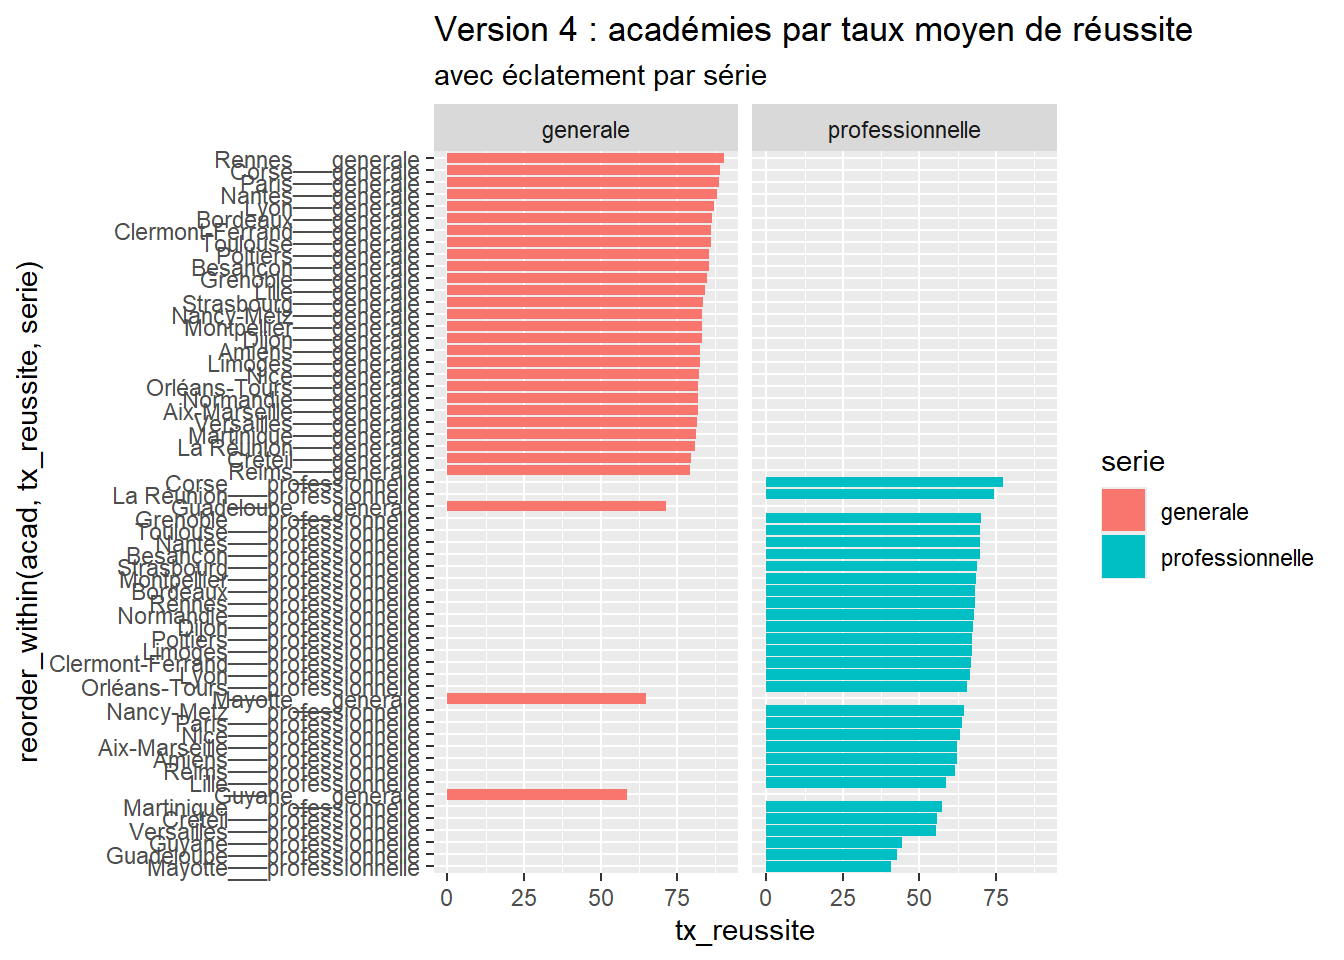
Le résultat obtenu est des plus curieux. La fonction reorder_within a apparemment créé des combinaisons entre acad et serie qui ne sont pas très jolies. Et l’axe vertical est illisible. C’est parce qu’il manque encore deux éléments :
- l’option
scales="free_y"dans la fonctionfacet_wrappour autoriser chaque série a avoir son axe vertical gradué indépendamment de l’autre - la fonction
scale_y_reordered()pour gérer un affichage plus classique des valeurs produites parreorder_within
ggplot(dnb_acad) +
  aes(y=reorder_within(acad, tx_reussite, serie),
      x=tx_reussite,
      fill=serie) +
  geom_col(position="dodge", show.legend = FALSE) +
  labs(title="Version 4 : académies par taux moyen de réussite",
       subtitle="avec éclatement par série") +
  scale_y_reordered() +
  facet_wrap(vars(serie),
             scales="free_y")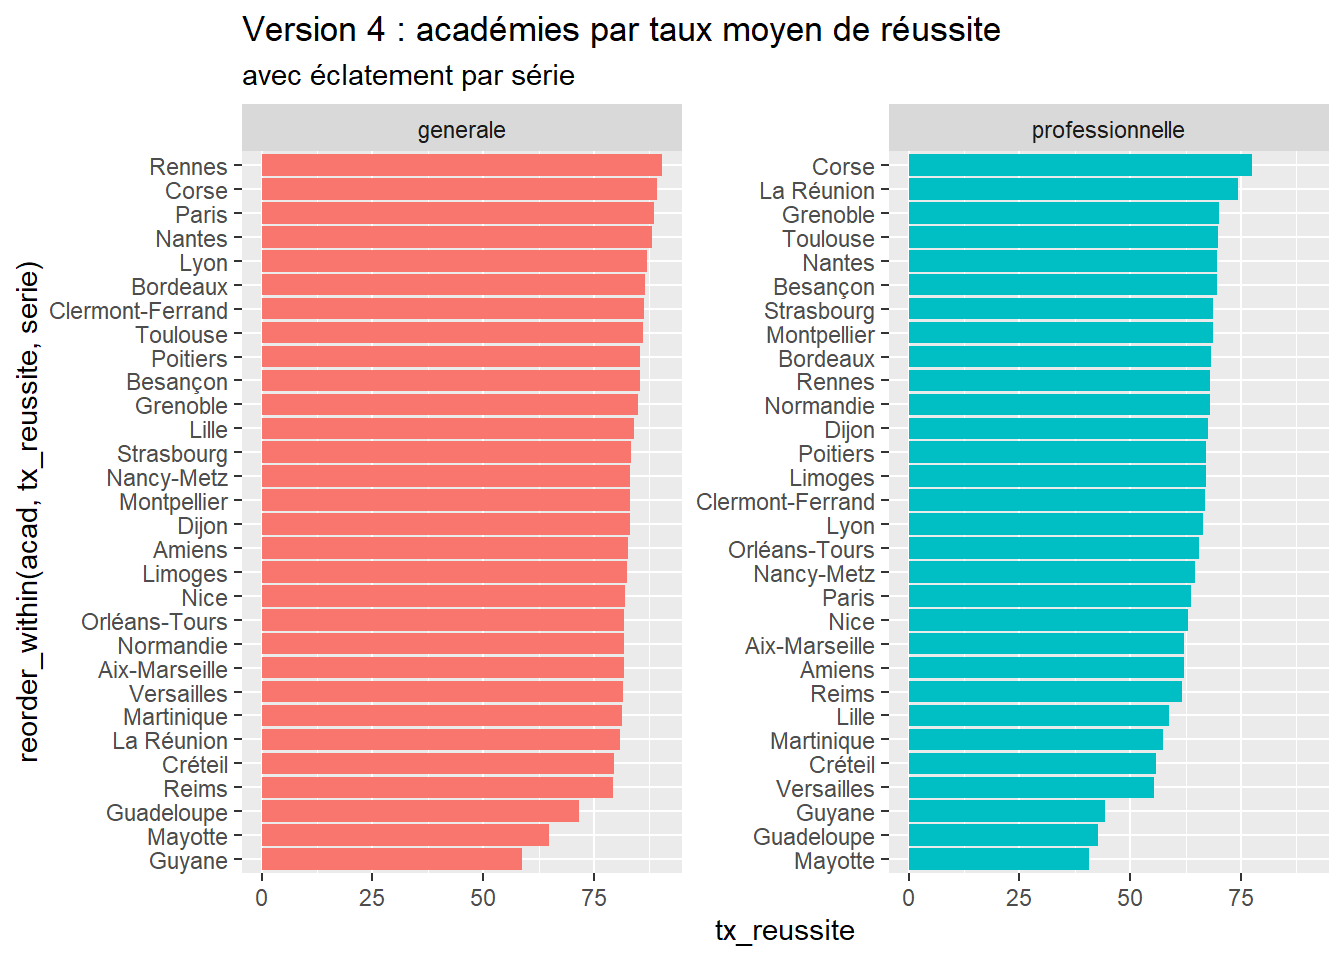
On obtient cette fois un résultat tout à fait satisfaisant.
Pour afficher toutes les modalités, même si elles sont absentes
Autre problème, principalement dans une légende : on voudrait y voir toutes les modalités possibles associées à ce vecteur, même si toutes ne sont pas présentes dans les données.
Voici un exemple avec les données penguins de {datasets} (un package préactivé) : toutes les espèces de manchots ne sont pas présentes sur toutes les îles.
palette <- c("Adelie"="tomato",
             "Chinstrap"="steelblue",
             "Gentoo"="black")
# intégralité des données : la légende montre les 3 espèces
ggplot(penguins %>%
         mutate(species = factor(species))) +
  aes(x=sex, y=body_mass, colour=species) +
  geom_boxplot() +
  scale_colour_manual(values=palette) +
  theme_classic()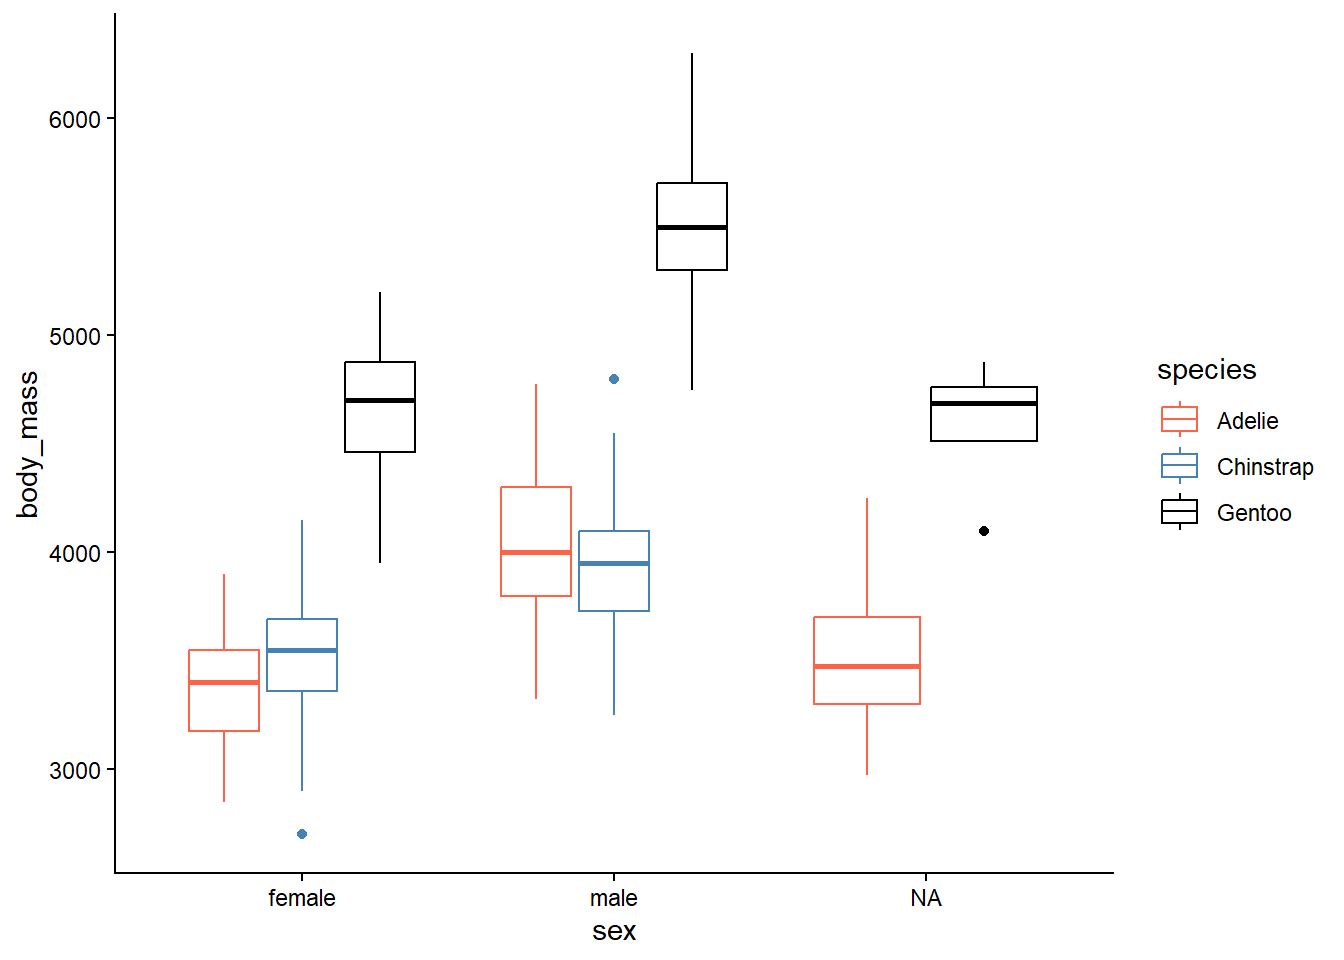
# filtre sur une île : on perd une des espèces dans la légende
ggplot(penguins %>%
         mutate(species = factor(species)) %>%
         filter(island == "Biscoe")) +
  aes(x=sex, y=body_mass, colour=species) +
  geom_boxplot() +
  scale_colour_manual(values=palette) +
  theme_classic()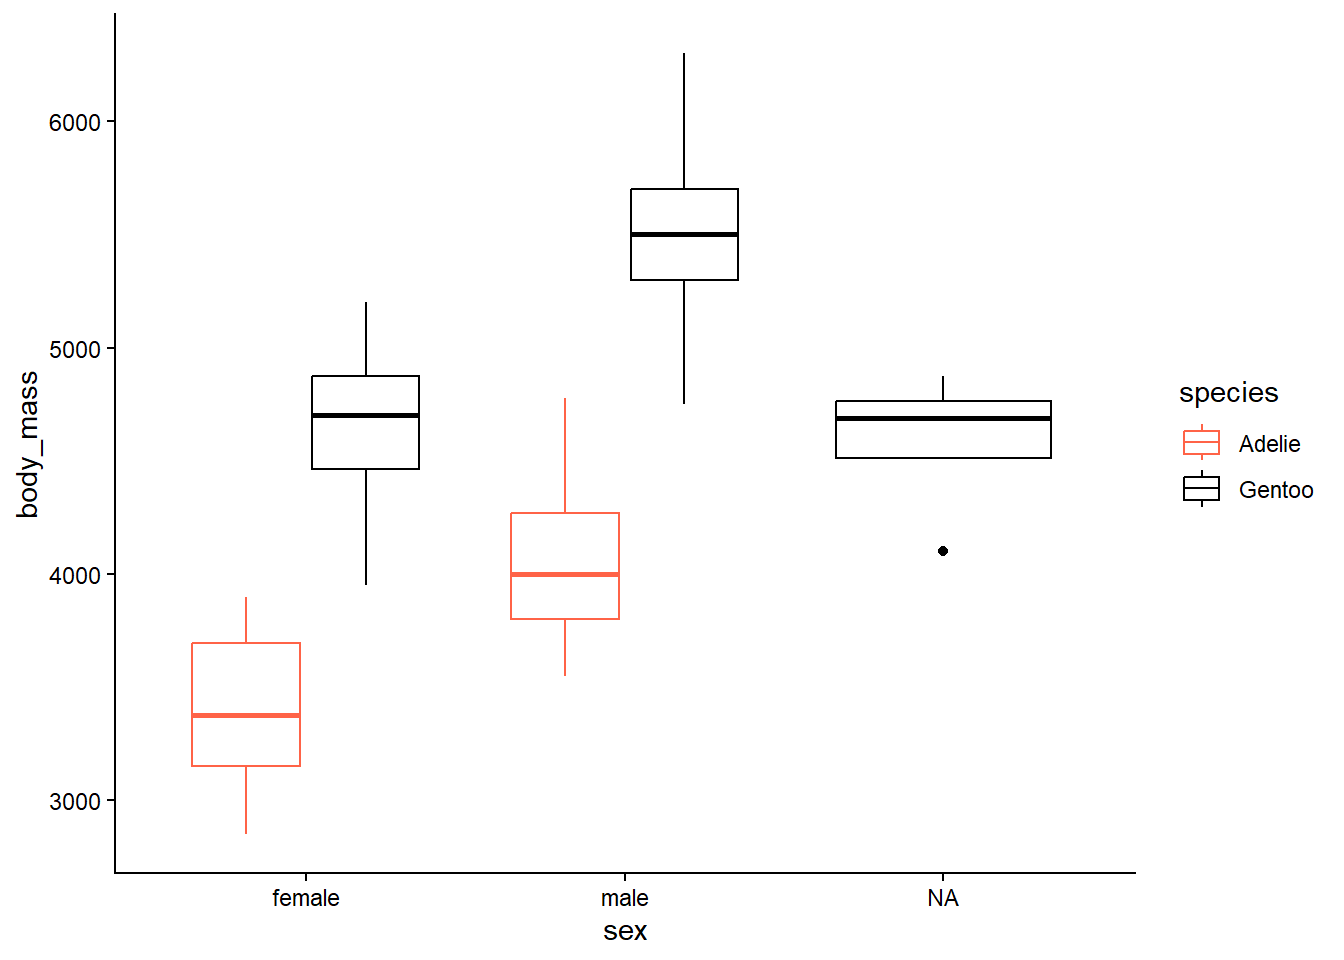
Le fait que le vecteur species soit un factor est indispensable pour espérer avoir une légende complète dans le deuxième graphique, celui qui ne concerne qu’une île. Mais ce n’est pas suffisant et il faut également :
- expliciter l’option
show.legend=TRUEdans la géométrie qui génère la légende (ici,geom_boxplot) - ajouter l’option
drop=FALSEà la fonctionscaleassociée à la légende, iciscale_colour_manual
ggplot(penguins %>%
         mutate(species = factor(species)) %>%
         filter(island == "Biscoe")) +
  aes(x=sex, y=body_mass, colour=species) +
  geom_boxplot(show.legend = TRUE) +
  scale_colour_manual(values=palette,
                      drop=FALSE) +
  theme_classic()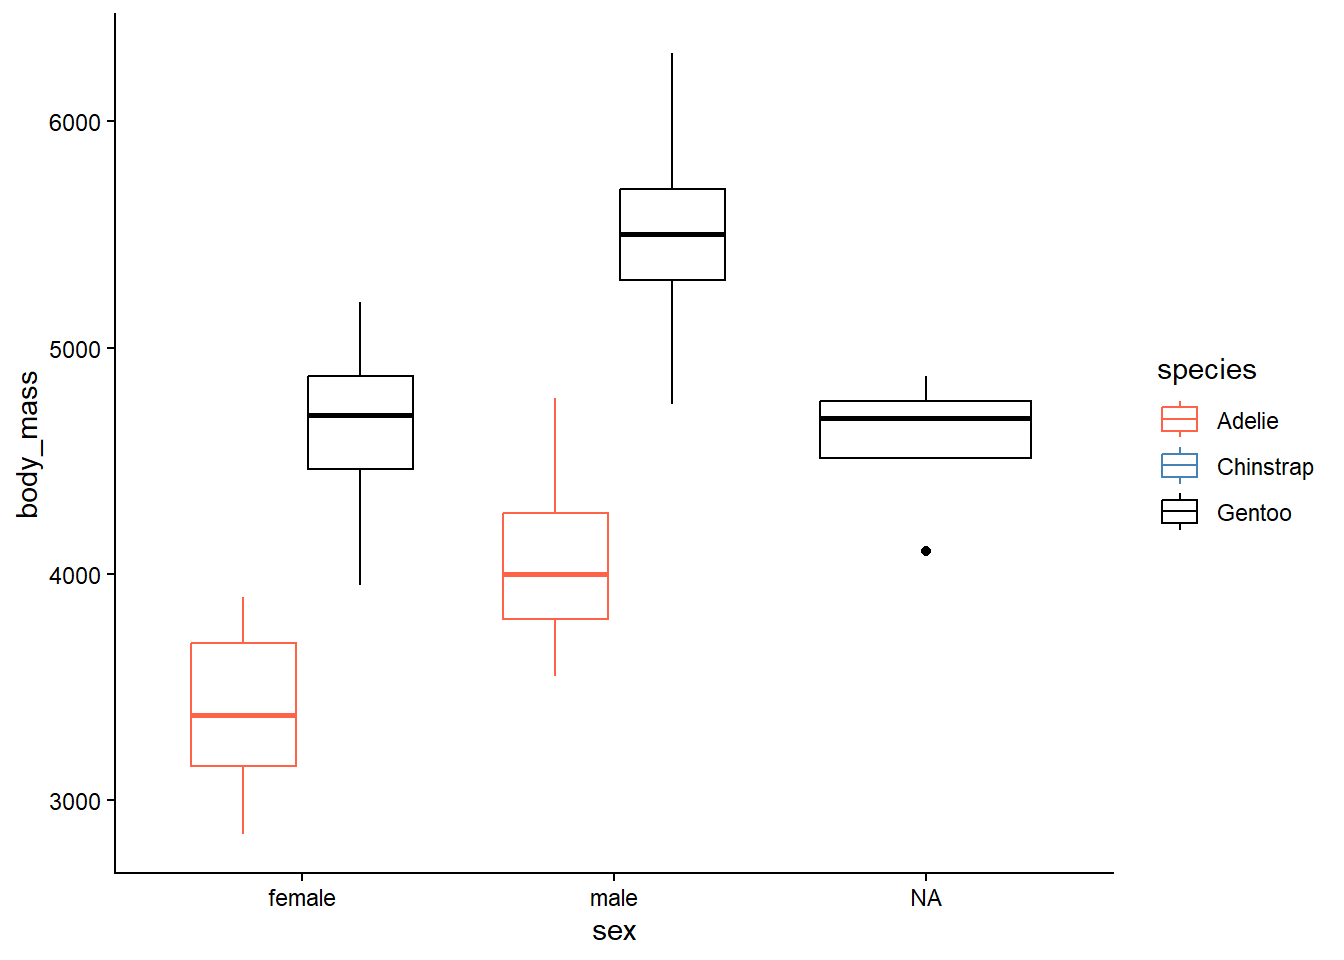
Dans un tableau
Les problématiques au niveau d’un tableau sont les mêmes que pour un graphique :
- pouvoir paramétrer l’ordre des lignes ou des colonnes du tableau
- pouvoir faire apparaître systématiquement des modalités, même si elles sont absentes des données.
Ce dernier point est particulièrement crucial si on doit injecter le tableau produit par R dans une maquette Excel où un tableau d’une certaine taille a déjà été préparé et mis en forme. Il importe donc que le nombre de lignes et de colonnes du tableau produit par R soit conforme à la maquette, même si une valeur prévue vient à manquer dans les données.
Pour personnaliser l’ordre des modalités
Evidemment, tant que le tableau est un data.frame, on a la ressource de le trier comme n’importe quel jeu de données, par exemple avec dplyr::arrange. L’intérêt du factor est ici plutôt de fournir un ordre par défaut pour que l’aspect du tableau soit reproductible indépendamment des données, par exemple pour l’ordre des niveaux de l’école primaire CP / CE1 / CE2 / CM1 / CM2.
Les fonctions utilisées ici sont les mêmes que celles présentées dans les exemples précédents.
library(flextable) # tableaux mis en forme

penguins %>%
  count(species) %>%
flextable()|
species |
n |
|---|---|
|
Adelie |
152 |
|
Chinstrap |
68 |
|
Gentoo |
124 |
penguins %>%
  mutate(species = fct_infreq(species)) %>%
  count(species) %>%
flextable()|
species |
n |
|---|---|
|
Adelie |
152 |
|
Gentoo |
124 |
|
Chinstrap |
68 |
Pour afficher toutes les modalités, même si elles sont absentes
Là encore, disposer d’un factor est nécessaire, mais pas suffisant. Dans la construction de résumés statistiques avec {dplyr}, il faudra impérativement ajouter l’option .drop=FALSE dans la fonction group_by (il n’y a pas d’équivalent dans l’option .by de la fonction summarise ; il faut donc absolument utiliser group_by – et de préférence aussi ungroup par sécurité – dans notre cas).
penguins %>%
  mutate(species = factor(species)) %>%
  filter(island == "Biscoe") %>%
  group_by(species, .drop=FALSE) %>%
  summarise(n = n()) %>%
  ungroup() %>%
flextable()|
species |
n |
|---|---|
|
Adelie |
44 |
|
Chinstrap |
0 |
|
Gentoo |
124 |
Les alternatives usuelles (tidyr::fill ou une jointure avec un data.frame énumérant toutes les modalités attendues) sont également possibles mais cette option .drop est beaucoup plus ramassée et fiable.
En conclusion
L’intérêt premier d’un factor c’est de gagner de la place.Dans cette perspective, la création rapide de factors dans vos data.frame est une bonne chose, mais attention, la manipulation de données qui s’ensuivra peut réserver quelques (mauvaises) surprises, par exemple dans les conversions, les jointures, etc. Méfiance donc.
Il permet également de personnaliser l’ordre d’affichage dans un tableau ou un graphique, d’en stabiliser les choix (nombre de lignes / de colonnes, cohérence des légendes) indépendamment de la présence ou non de modalités dans les données présentées. Dans cette optique, mieux vaut faire toute la gestion de données avec des types plus classiques (caractère, numérique) et convertir en factor au moment de construire tableaux graphiques : alors le factor est un outil fantastique au service de la lisibilité de vos rapports.
Adoptez-le si ce n’est déjà fait !