Contexte
Au détour d’une discussion familiale au dîner, pendant les vacances, surviennent quelques questions sans réponse évidente sur les prénoms : est-ce qu’ils sont plus variés aujourd’hui qu’au siècle dernier ? Plus longs ? Plus courts ? etc. Plutôt que d’interroger une IA, la solution la plus pertinente est de télécharger le fichier des prénoms mis à disposition par l’Insee ici en format Parquet (il y a aussi du CSV).
Ce qui est chouette avec ce genre de données, c’est qu’on n’en a jamais fait le tour et qu’il y aura toujours d’autres angles d’analyse possibles. L’idée ici était plutôt d’avoir quelques éléments de réponse aux questions familiales, et de faire du R autour de {arrow} et {ggplot2}.
J’ai choisi de reproduire ici mes codes quasiment bruts, sans chercher à les optimiser. Il y a sûrement matière à faire mieux, en évitant des répétitions (un thème dans {ggplot2} par exemple) mais c’était juste un petit projet de vacances, pas un code pour un client.
Mise en place
Après avoir téléchargé le fichier Parquet et mis dans un répertoire ad hoc, activons les packages utiles.
library(arrow)      # connection fichiers Parquet
library(duckdb)     # base de données analytique
library(dplyr)      # requêtes
library(dbplyr)     # traduction dplyr > SQL pour DuckDB
library(ggplot2)    # graphiques
library(patchwork)  # combinaison de graphiques
library(ggtext)     # texte mis en forme dans des titres
library(tidyr)      # pivots
library(tidytext)   # équivalent de fct_reorder dans un groupement
library(FactoMineR) # caractérisation (sur-représentation significative)
Plutôt que de requêter directement dans le fichier Parquet avec {arrow}, je préfère passer par une couche DuckDB qui permet de mieux visualiser les données.
pre_pqt <- open_dataset("c:/temp/prenoms/")
# démarrage DuckDB
bd <- dbConnect(duckdb())
# lien DuckDB vers Arrow vers Parquet
duckdb_register_arrow(bd, "pre_tbl", pre_pqt)
# aperçu des données
tbl(bd, "pre_tbl")
# Source:   table<pre_tbl> [?? x 7]
# Database: DuckDB 1.4.4 [PC@Windows 10 x64:R 4.5.3/:memory:]
   sexe  prenom  periode niveau_geographique geographie valeur  rang
   <chr> <chr>   <chr>   <chr>               <chr>       <int> <int>
 1 1     GABRIEL 2025    FRANCE              F            4625     1
 2 1     NOAH    2025    FRANCE              F            3465     2
 3 1     LÉO     2025    FRANCE              F            3420     3
 4 1     RAPHAËL 2025    FRANCE              F            3285     4
 5 1     LOUIS   2025    FRANCE              F            3260     5
 6 1     JULES   2025    FRANCE              F            3040     6
 7 1     ARTHUR  2025    FRANCE              F            2875     7
 8 1     LÉON    2025    FRANCE              F            2835     8
 9 1     ADAM    2025    FRANCE              F            2810     9
10 1     MAËL    2025    FRANCE              F            2700    10
# ℹ more rows
# couleurs par sexe
palette <- c("1" = "goldenrod2", "2" = "orchid3",
"garçons" = "goldenrod2", "filles" = "orchid3")
Nombre de prénoms distincts
Probablement une des analyses les plus simples, l’occasion de prendre les données en main. Pour ne pas faire les comptages deux fois il est important de sélectionner un seul niveau géographique (on a France entière, région ou département au choix).
distincts <- tbl(bd, "pre_tbl") %>%
  filter(niveau_geographique == "FRANCE") %>%
  group_by(periode, sexe) %>%
  summarise(nb_distinct = n_distinct(prenom)) %>%
  ungroup() %>%
  arrange(periode, sexe) %>%
  collect() %>%
  mutate(annee = as.integer(periode),
         sexe = factor(sexe, labels=c("garçons","filles")))
`summarise()` has grouped output by "periode". You can override using the
`.groups` argument.ggplot(distincts) +
aes(x=annee,
y=nb_distinct,
colour=sexe) +
geom_line(show.legend = FALSE) +
geom_text(aes(x=ifelse(annee==max(annee), annee, NA),
label=sexe),
vjust=0, hjust=-0.1,
show.legend = FALSE) +
theme_classic() +
scale_colour_manual(values = palette) +
scale_y_continuous(labels = ~ prettyNum(.x, big.mark = " ")) +
scale_x_continuous(breaks = seq(1900,2025, by=25),
expand = expansion(add=c(1,20))) +
labs(x="Année de naissance",
y="Nombre de prénoms distincts",
caption="Source : INSEE, fichier des prénoms 1900-2025")
Warning: Removed 250 rows containing missing values or values outside the scale range
(`geom_text()`).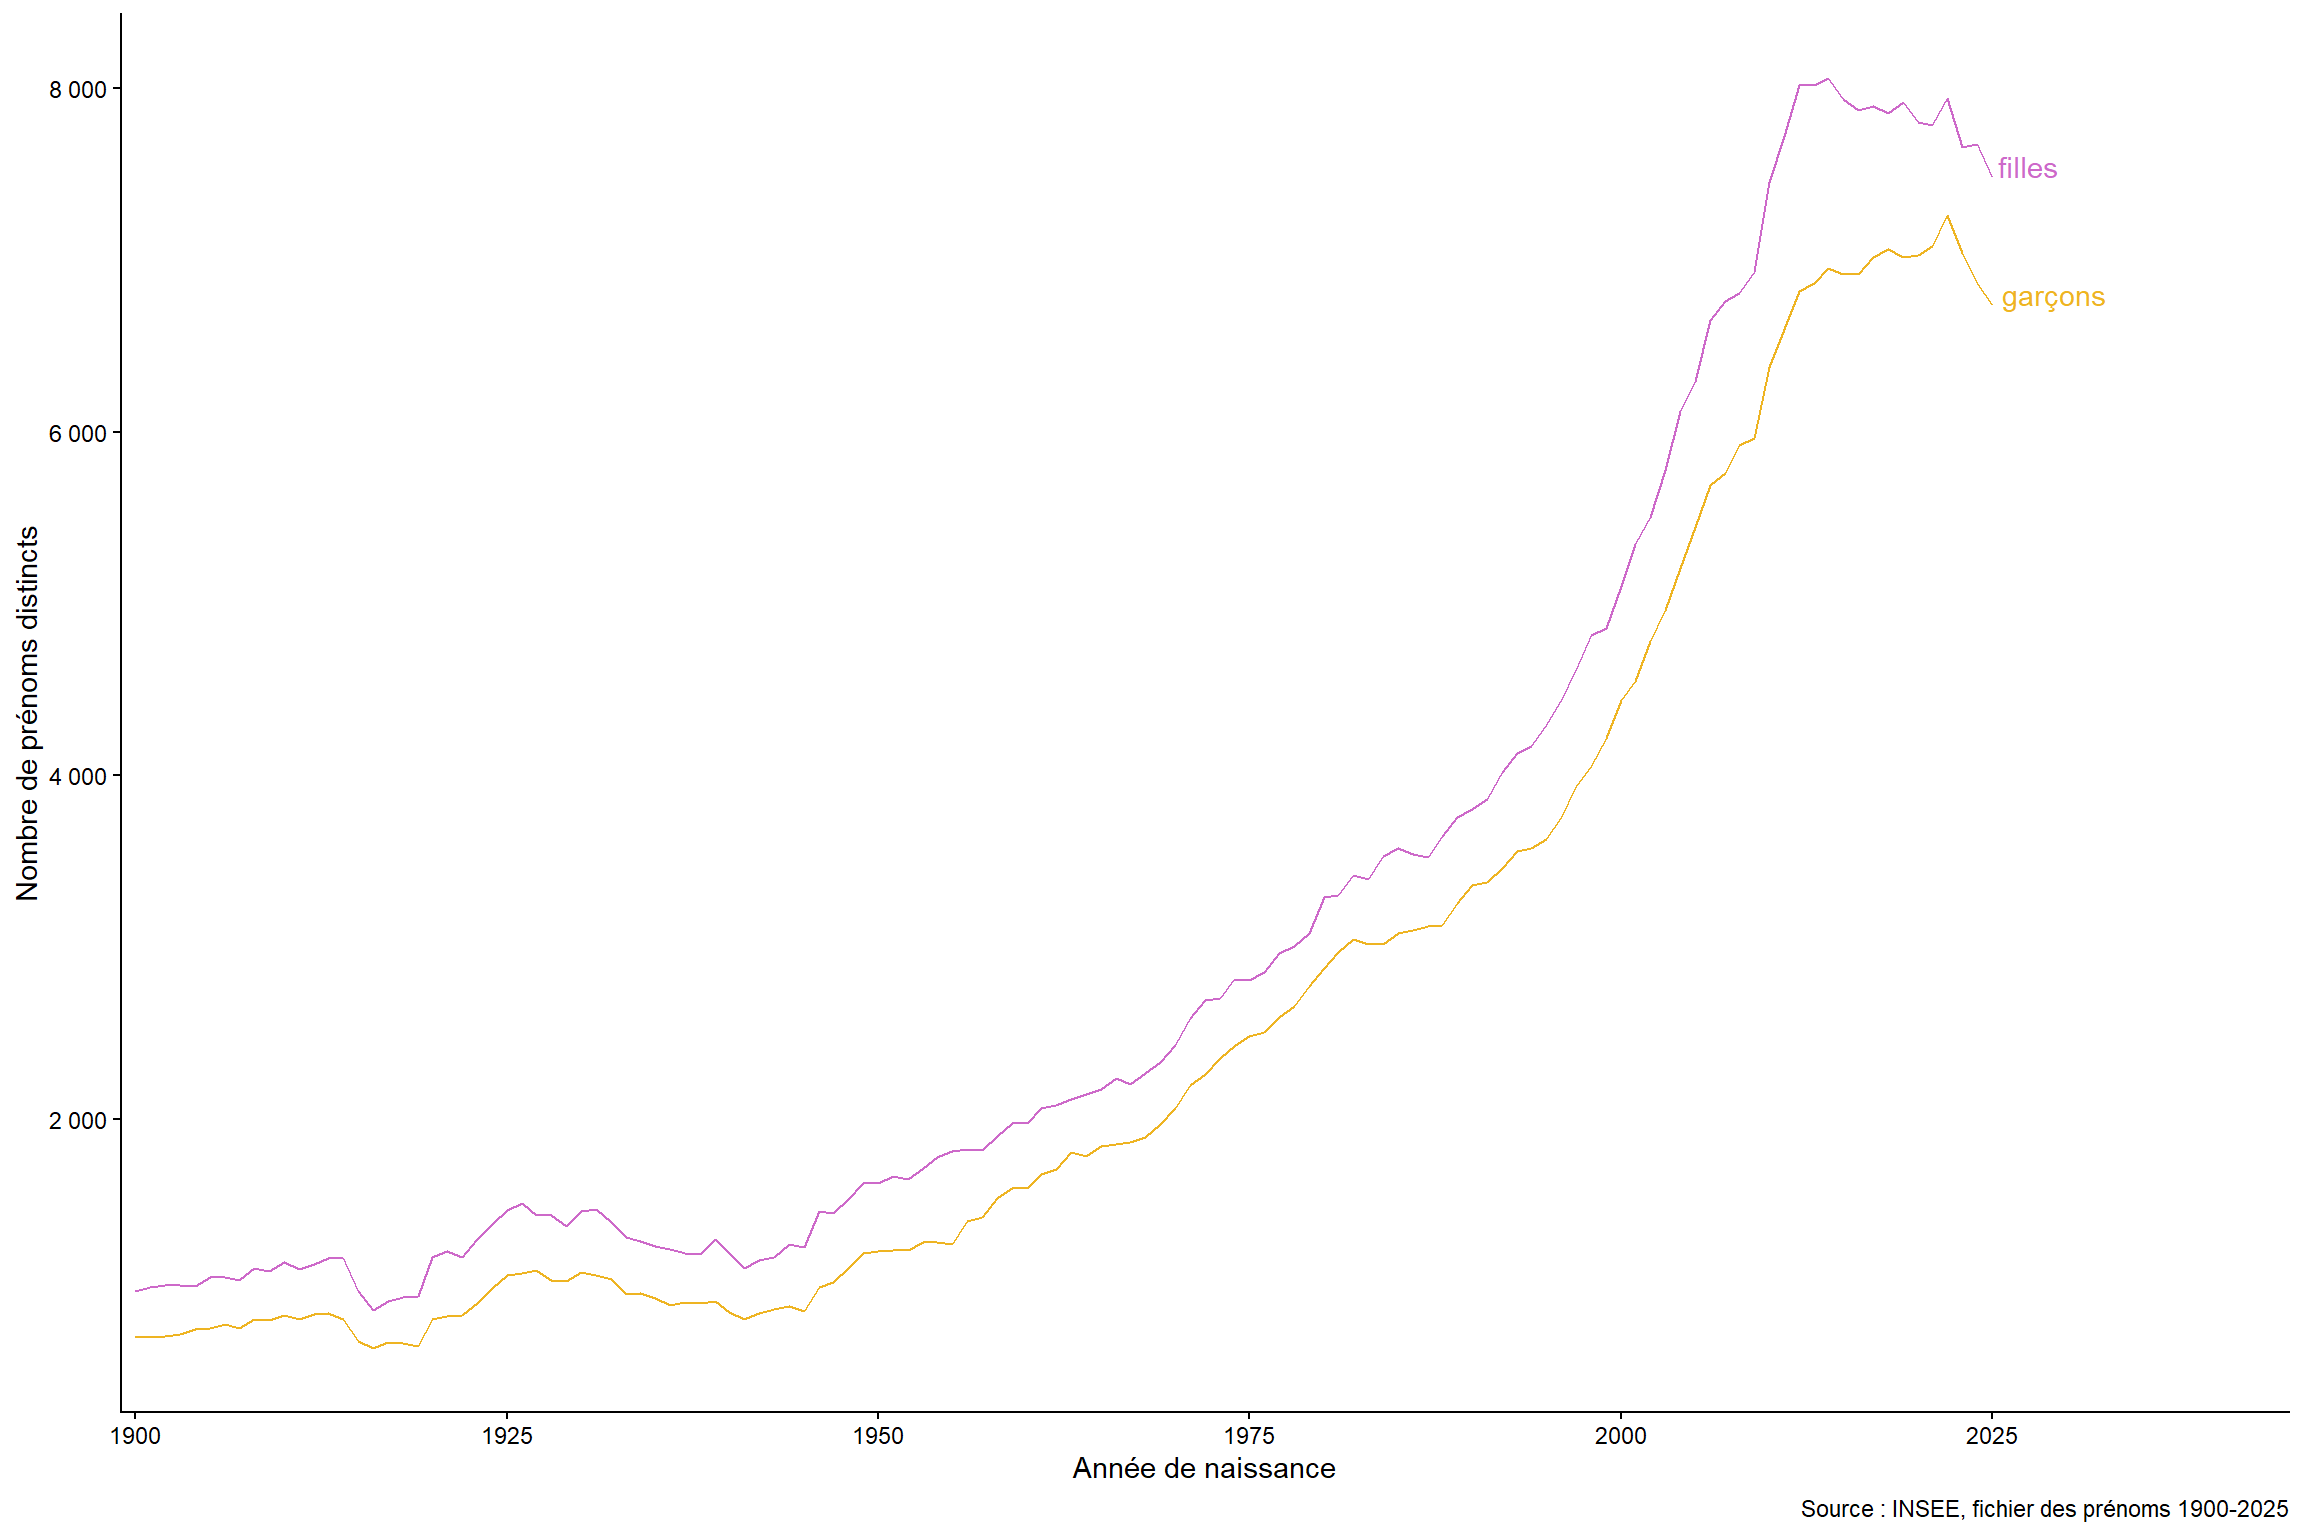
Le prénom le plus fréquent
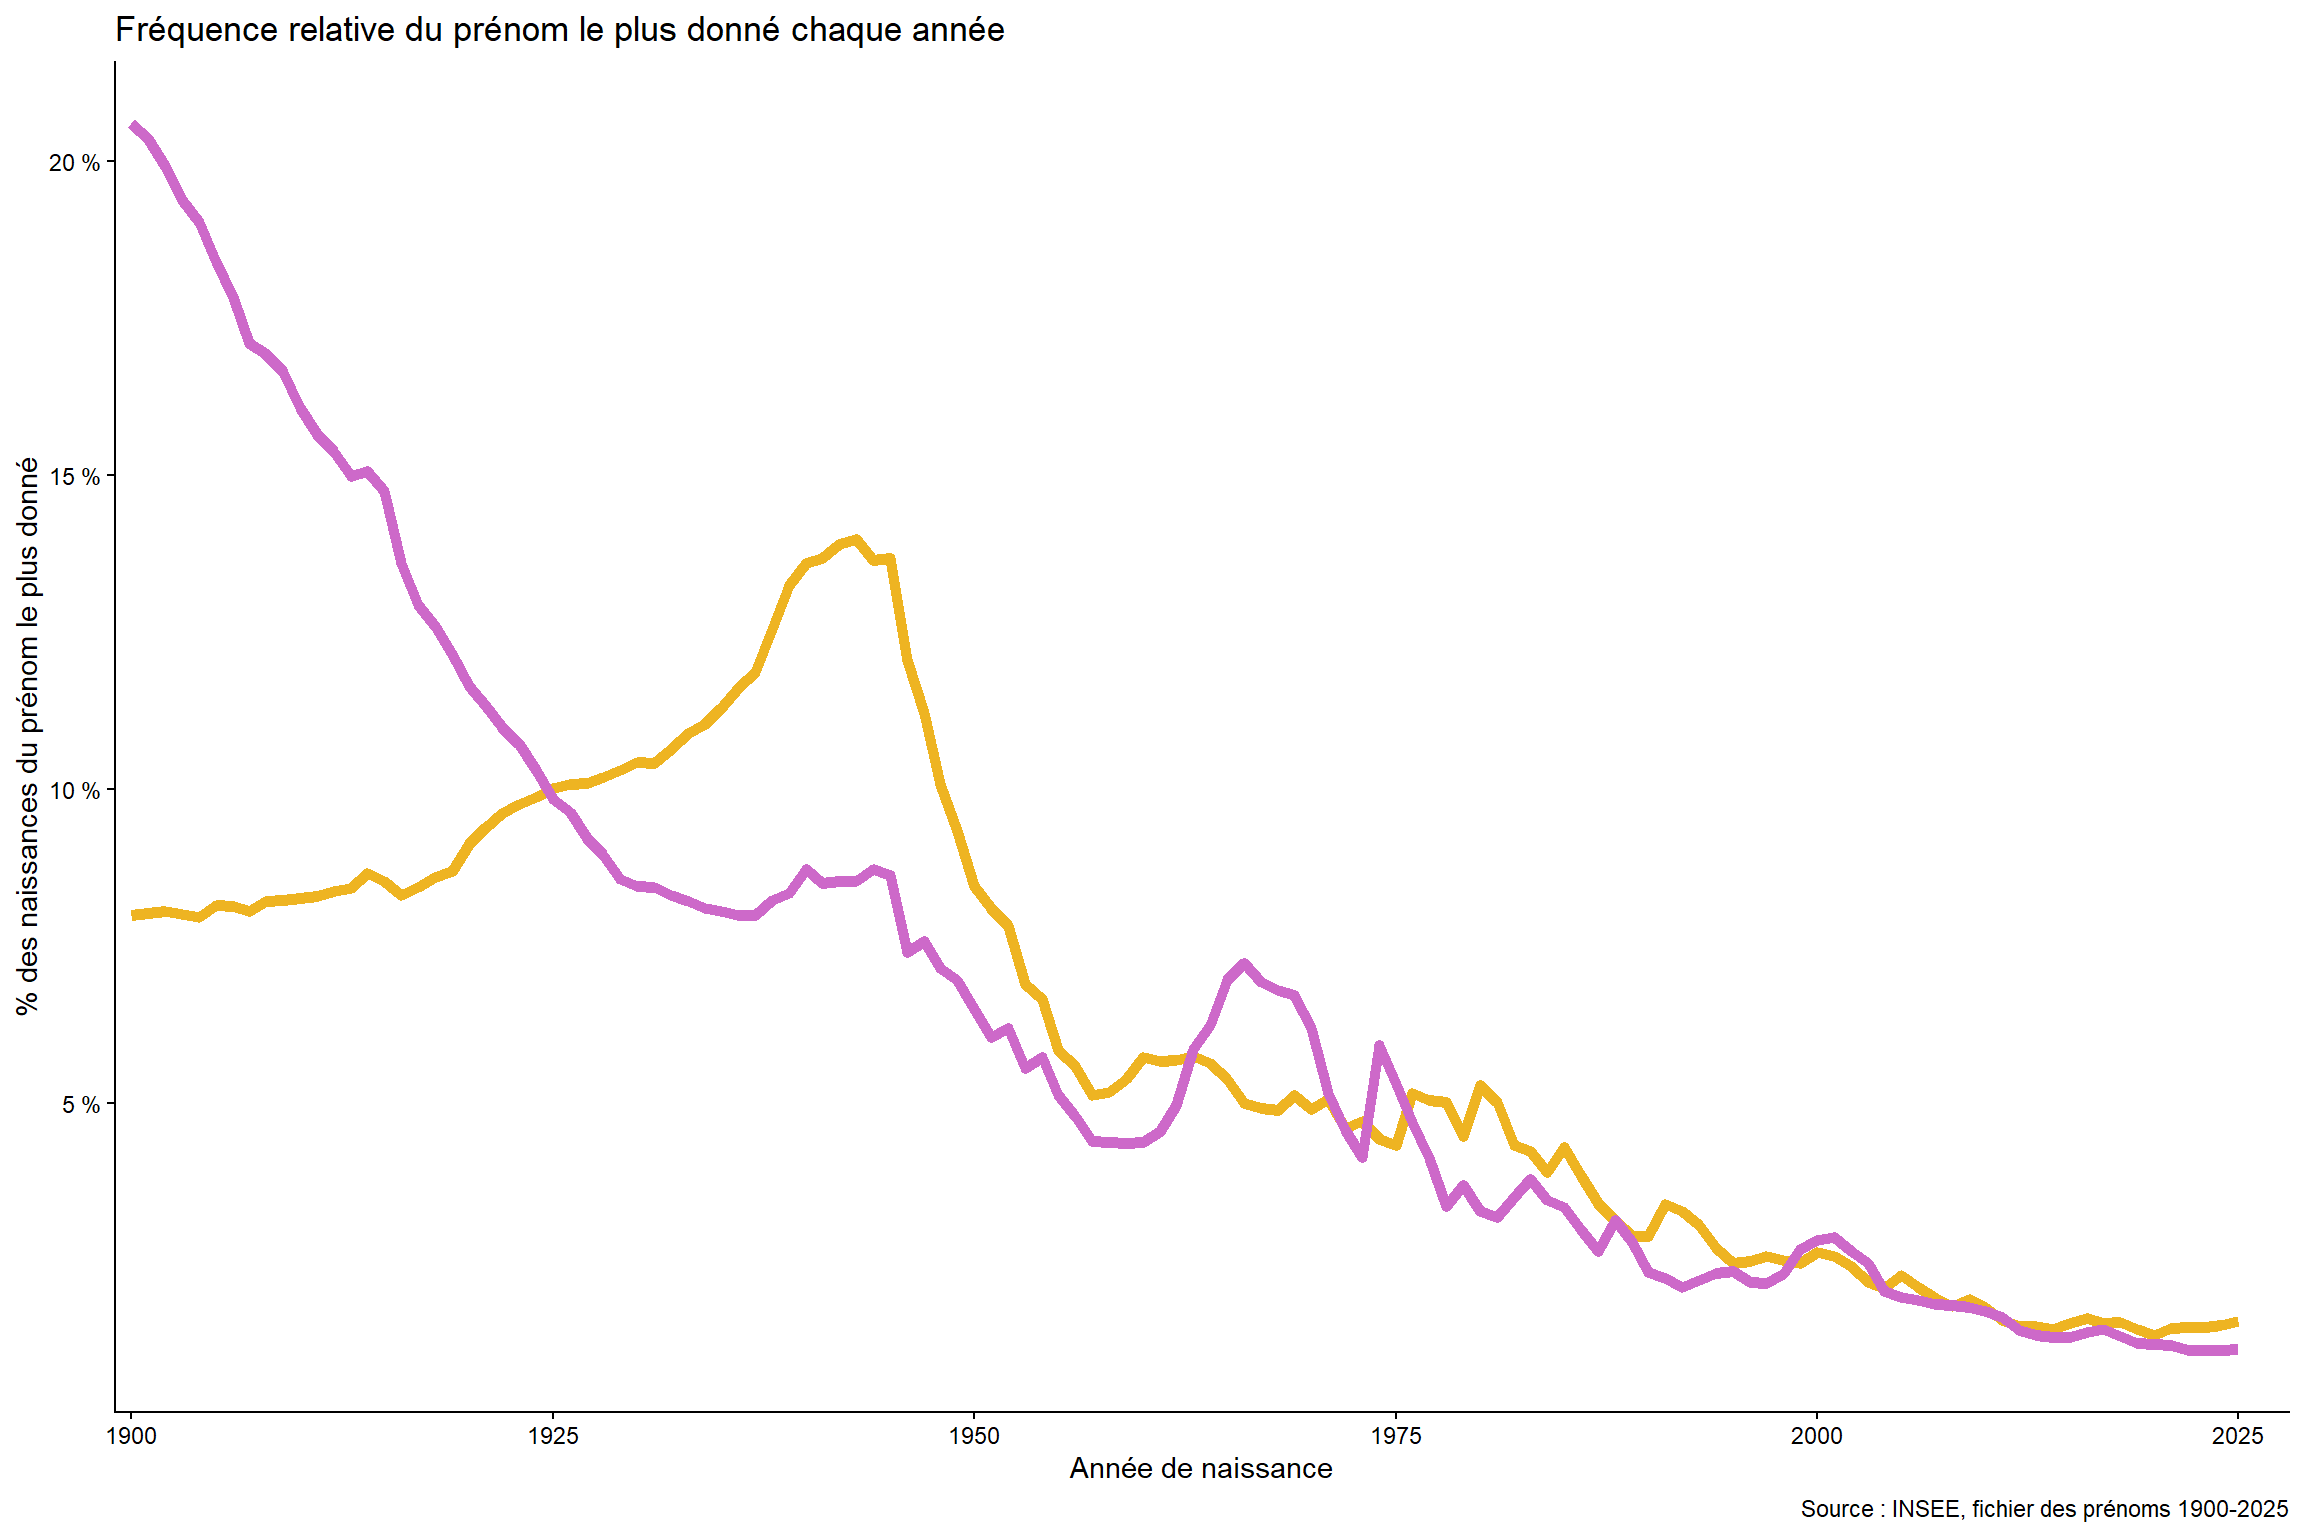
Après ce premier graphique, on peut se demander s’il y a une dispersion plus grande dans le choix des prénoms, ou une inflation du nombre de prénoms rarissimes. Pour en avoir une idée, on peut regarder l’évolution de la part des naissances de l’année associée au prénom le plus fréquent, au fil des ans.
frequent <- tbl(bd, "pre_tbl") %>%
  filter(niveau_geographique == "FRANCE") %>%
  mutate(pct_annee = valeur/sum(valeur),
         annee = as.integer(periode),
         .by=c(periode, sexe)) %>%
  filter(rang == 1) %>%
  arrange(periode) %>%
  collect()
Warning: Missing values are always removed in SQL aggregation functions.
Use `na.rm = TRUE` to silence this warning
This warning is displayed once every 8 hours.ggplot(frequent) +
aes(x=annee,
y=pct_annee,
colour=sexe) +
geom_line(show.legend = FALSE, lwd=2) +
theme_classic() +
scale_colour_manual(values = palette) +
scale_y_continuous(labels = ~ paste(.x*100, "%"),
breaks = seq(0,0.25, by=0.05)) +
scale_x_continuous(breaks = seq(1900,2025, by=25),
expand = expansion(add=c(1,3))) +
labs(title = "Fréquence relative du prénom le plus donné chaque année",
x="Année de naissance",
y="% des naissances du prénom le plus donné",
caption="Source : INSEE, fichier des prénoms 1900-2025")
Nombre moyen de lettres par prénom
Ici l’objet est de mesurer s’il y a raccourcissement des prénoms au fil du temps, la mode étant plus récemment à des prénoms très courts comme Tom ou Léa. J’ai finalement opté pour une simple moyenne du nombre de caractères, en comptant d’éventuels signes de ponctuation (espace, tiret). La médiane, elle, est constante sur toute la période 1900-2025.
longueurs <- tbl(bd, "pre_tbl") %>%
  filter(niveau_geographique == "FRANCE") %>%
  group_by(periode, sexe) %>%
  summarise(longueur_moy = mean(nchar(prenom))) %>%
  ungroup() %>%
  arrange(periode, sexe) %>%
  collect() %>%
  mutate(annee = as.integer(periode),
         sexe = factor(sexe, labels=c("garçons","filles")))
`summarise()` has grouped output by "periode". You can override using the
`.groups` argument.ggplot(longueurs) +
aes(x=annee,
y=longueur_moy,
colour=sexe) +
geom_line(show.legend = FALSE) +
geom_text(aes(x=ifelse(annee==max(annee), annee, NA),
label=sexe),
vjust=0, hjust=-0.1,
show.legend = FALSE) +
theme_classic() +
scale_colour_manual(values = palette) +
scale_y_continuous(labels = ~ prettyNum(.x, decimal.mark = ",")) +
scale_x_continuous(breaks = seq(1900,2025, by=25),
expand = expansion(add=c(1,20))) +
labs(x="Année de naissance",
y="Nombre moyen de caractères du prénom",
caption="Source : INSEE, fichier des prénoms 1900-2025")
Warning: Removed 250 rows containing missing values or values outside the scale range
(`geom_text()`).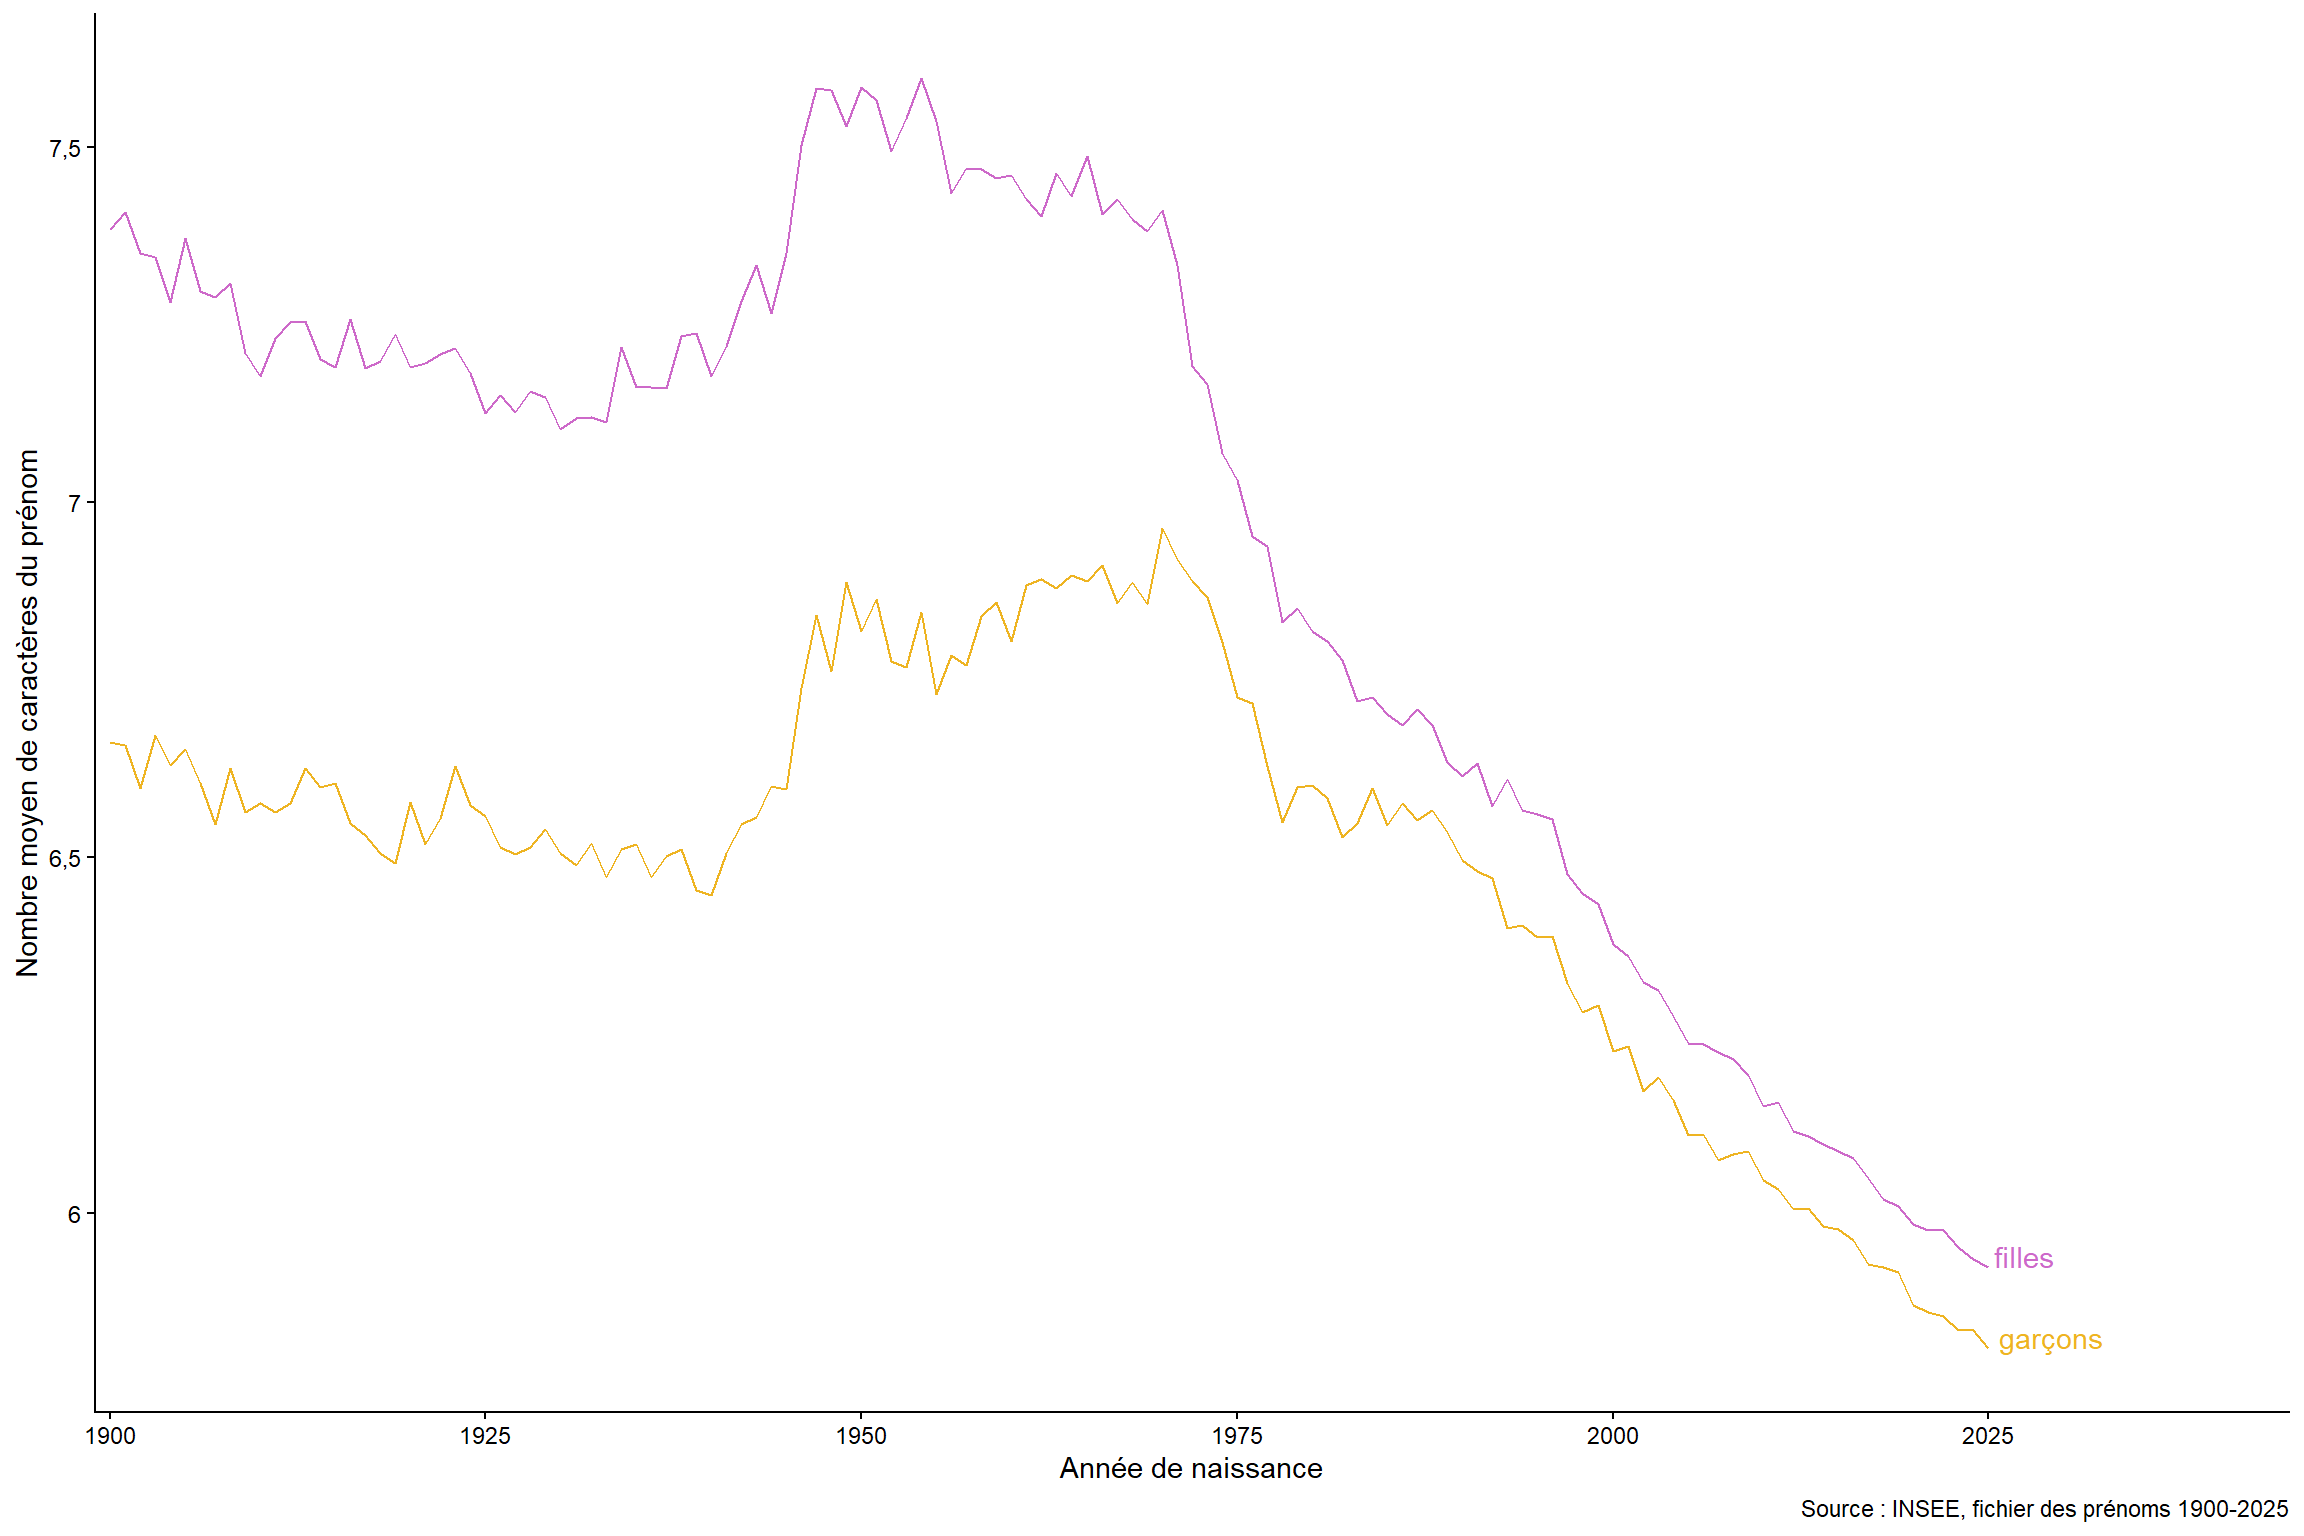
Les prénoms composés
On voit sur le graphique précédent une hausse de la longueur des prénoms après-guerre. Est-ce que ce sont des prénoms plus longs, ou des prénoms composés ? L’indicateur est ici, sur le total de naissances de l’année, la part que représentent des prénoms contenant un tiret.
comp <- tbl(bd, "pre_tbl") %>%
  filter(niveau_geographique == "FRANCE") %>%
  mutate(prenom_compose = ifelse(
    sql("len(string_split_regex(prenom, '[ -]'))") > 1,
    1,
    0
  )) %>%
  group_by(periode, sexe) %>%
  summarise(pct_comp = mean(prenom_compose)*100) %>%
  ungroup() %>%
  arrange(periode, sexe) %>%
  collect() %>%
  mutate(annee = as.integer(periode),
         sexe = factor(sexe, labels=c("garçons","filles")))
`summarise()` has grouped output by "periode". You can override using the
`.groups` argument.ggplot(comp) +
aes(x=annee,
y=pct_comp,
colour=sexe) +
geom_line(show.legend = FALSE) +
geom_text(aes(x=ifelse(annee==max(annee), annee, NA),
label=sexe),
vjust=0, hjust=-0.1,
show.legend = FALSE) +
theme_classic() +
scale_colour_manual(values = palette) +
scale_y_continuous(labels = ~ paste(.x, "%")) +
scale_x_continuous(breaks = seq(1900,2025, by=25),
expand = expansion(add=c(1,20))) +
labs(x="Année de naissance",
y="% de prénoms composés",
caption="Source : INSEE, fichier des prénoms 1900-2025")
Warning: Removed 250 rows containing missing values or values outside the scale range
(`geom_text()`).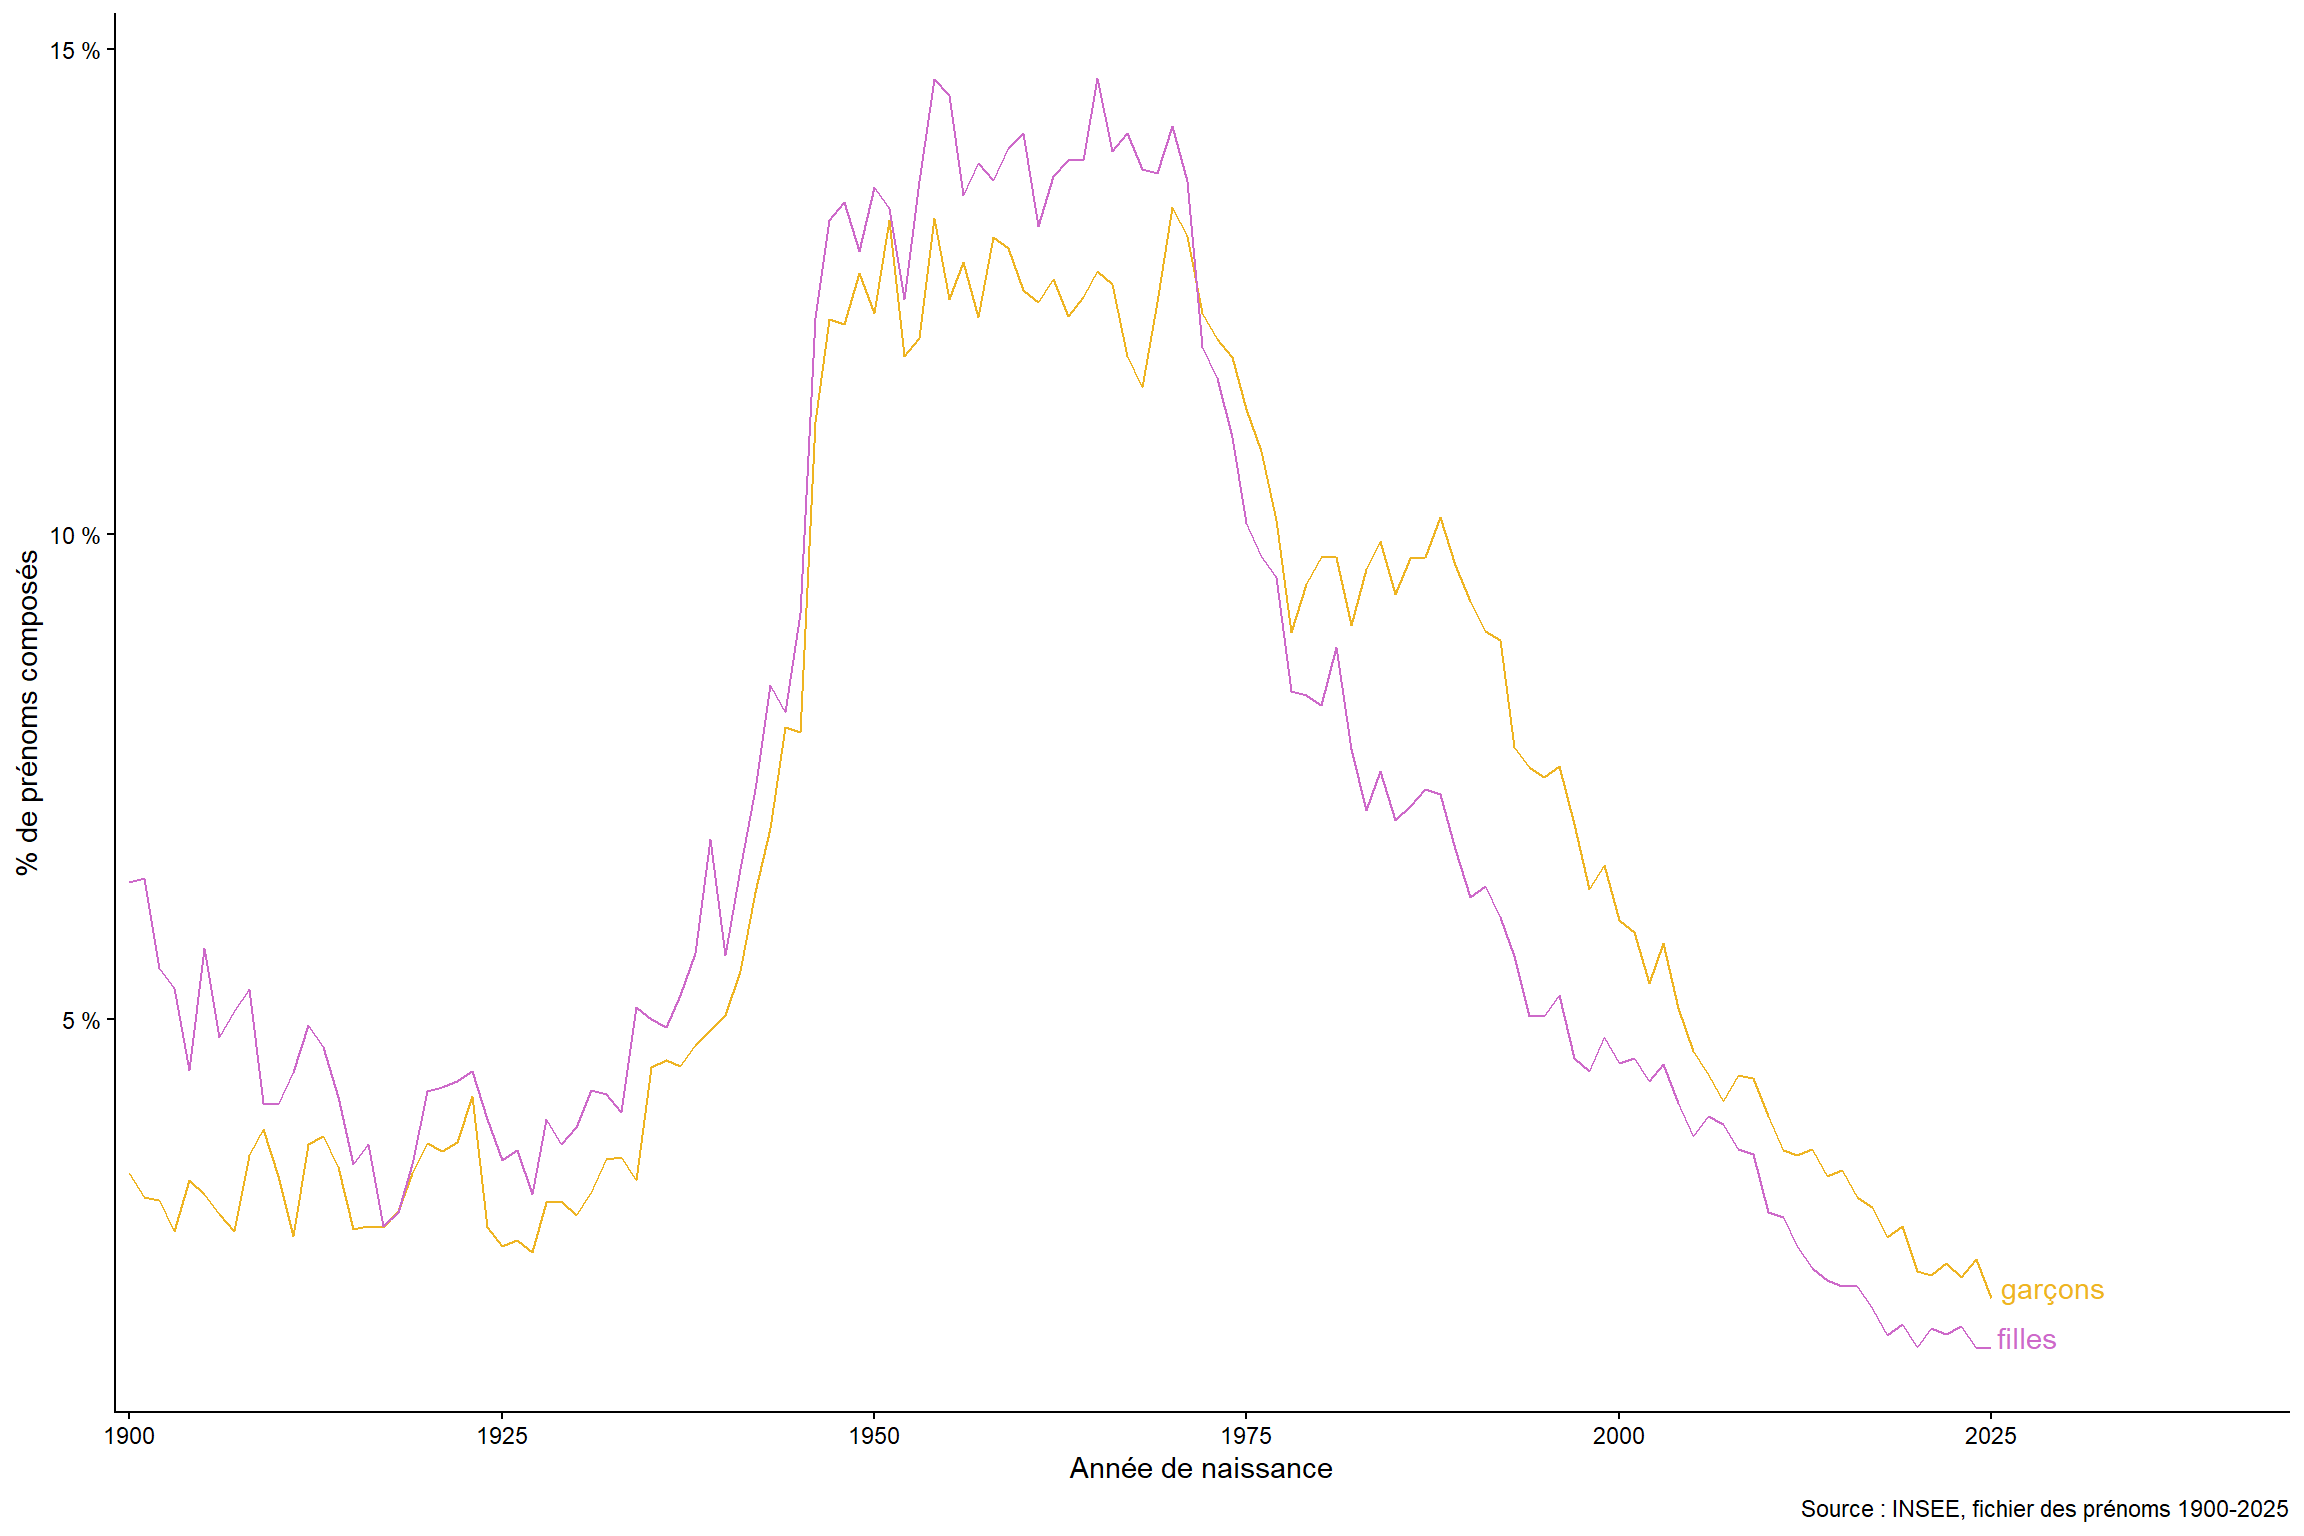
Les prénoms contenant un K, un Y ou un Z
Une autre question familiale avait trait à l’orthographe des prénoms. En tournant autour de ce concept un peu dur à mesurer (je cherche encore comme décompter le nombre de graphies variantes d’un même prénom), j’ai voulu mesurer quelque chose de beaucoup plus simple : au lieu de repérer des tirets comme dans le cas précédent, je vais repérer des lettres plus rares de l’alphabet que sont le K, le Y et le Z. Un choix totalement arbitraire de ma part et sûrement pas défendable si je devais argumenter pour le légitimer.
kyz <- tbl(bd, "pre_tbl") %>%
  filter(niveau_geographique == "FRANCE") %>%
  mutate(prenom_kyz = ifelse(
    stringr::str_detect(prenom, "[KYZ]"),
    1,
    0
  )) %>%
  group_by(periode, sexe) %>%
  summarise(pct_kyz = mean(prenom_kyz)*100) %>%
  ungroup() %>%
  arrange(periode, sexe) %>%
  collect() %>%
  mutate(annee = as.integer(periode),
         sexe = factor(sexe, labels=c("garçons","filles")))
`summarise()` has grouped output by "periode". You can override using the
`.groups` argument.ggplot(kyz) +
aes(x=annee,
y=pct_kyz,
colour=sexe) +
geom_line(show.legend = FALSE) +
geom_text(aes(x=ifelse(annee==max(annee), annee, NA),
label=sexe),
vjust=0, hjust=-0.1,
show.legend = FALSE) +
theme_classic() +
scale_colour_manual(values = palette) +
scale_y_continuous(labels = ~ paste(.x, "%")) +
scale_x_continuous(breaks = seq(1900,2025, by=25),
expand = expansion(add=c(1,20))) +
labs(x="Année de naissance",
y="% de prénoms contenant un K, un Y ou un Z",
caption="Source : INSEE, fichier des prénoms 1900-2025")
Warning: Removed 250 rows containing missing values or values outside the scale range
(`geom_text()`).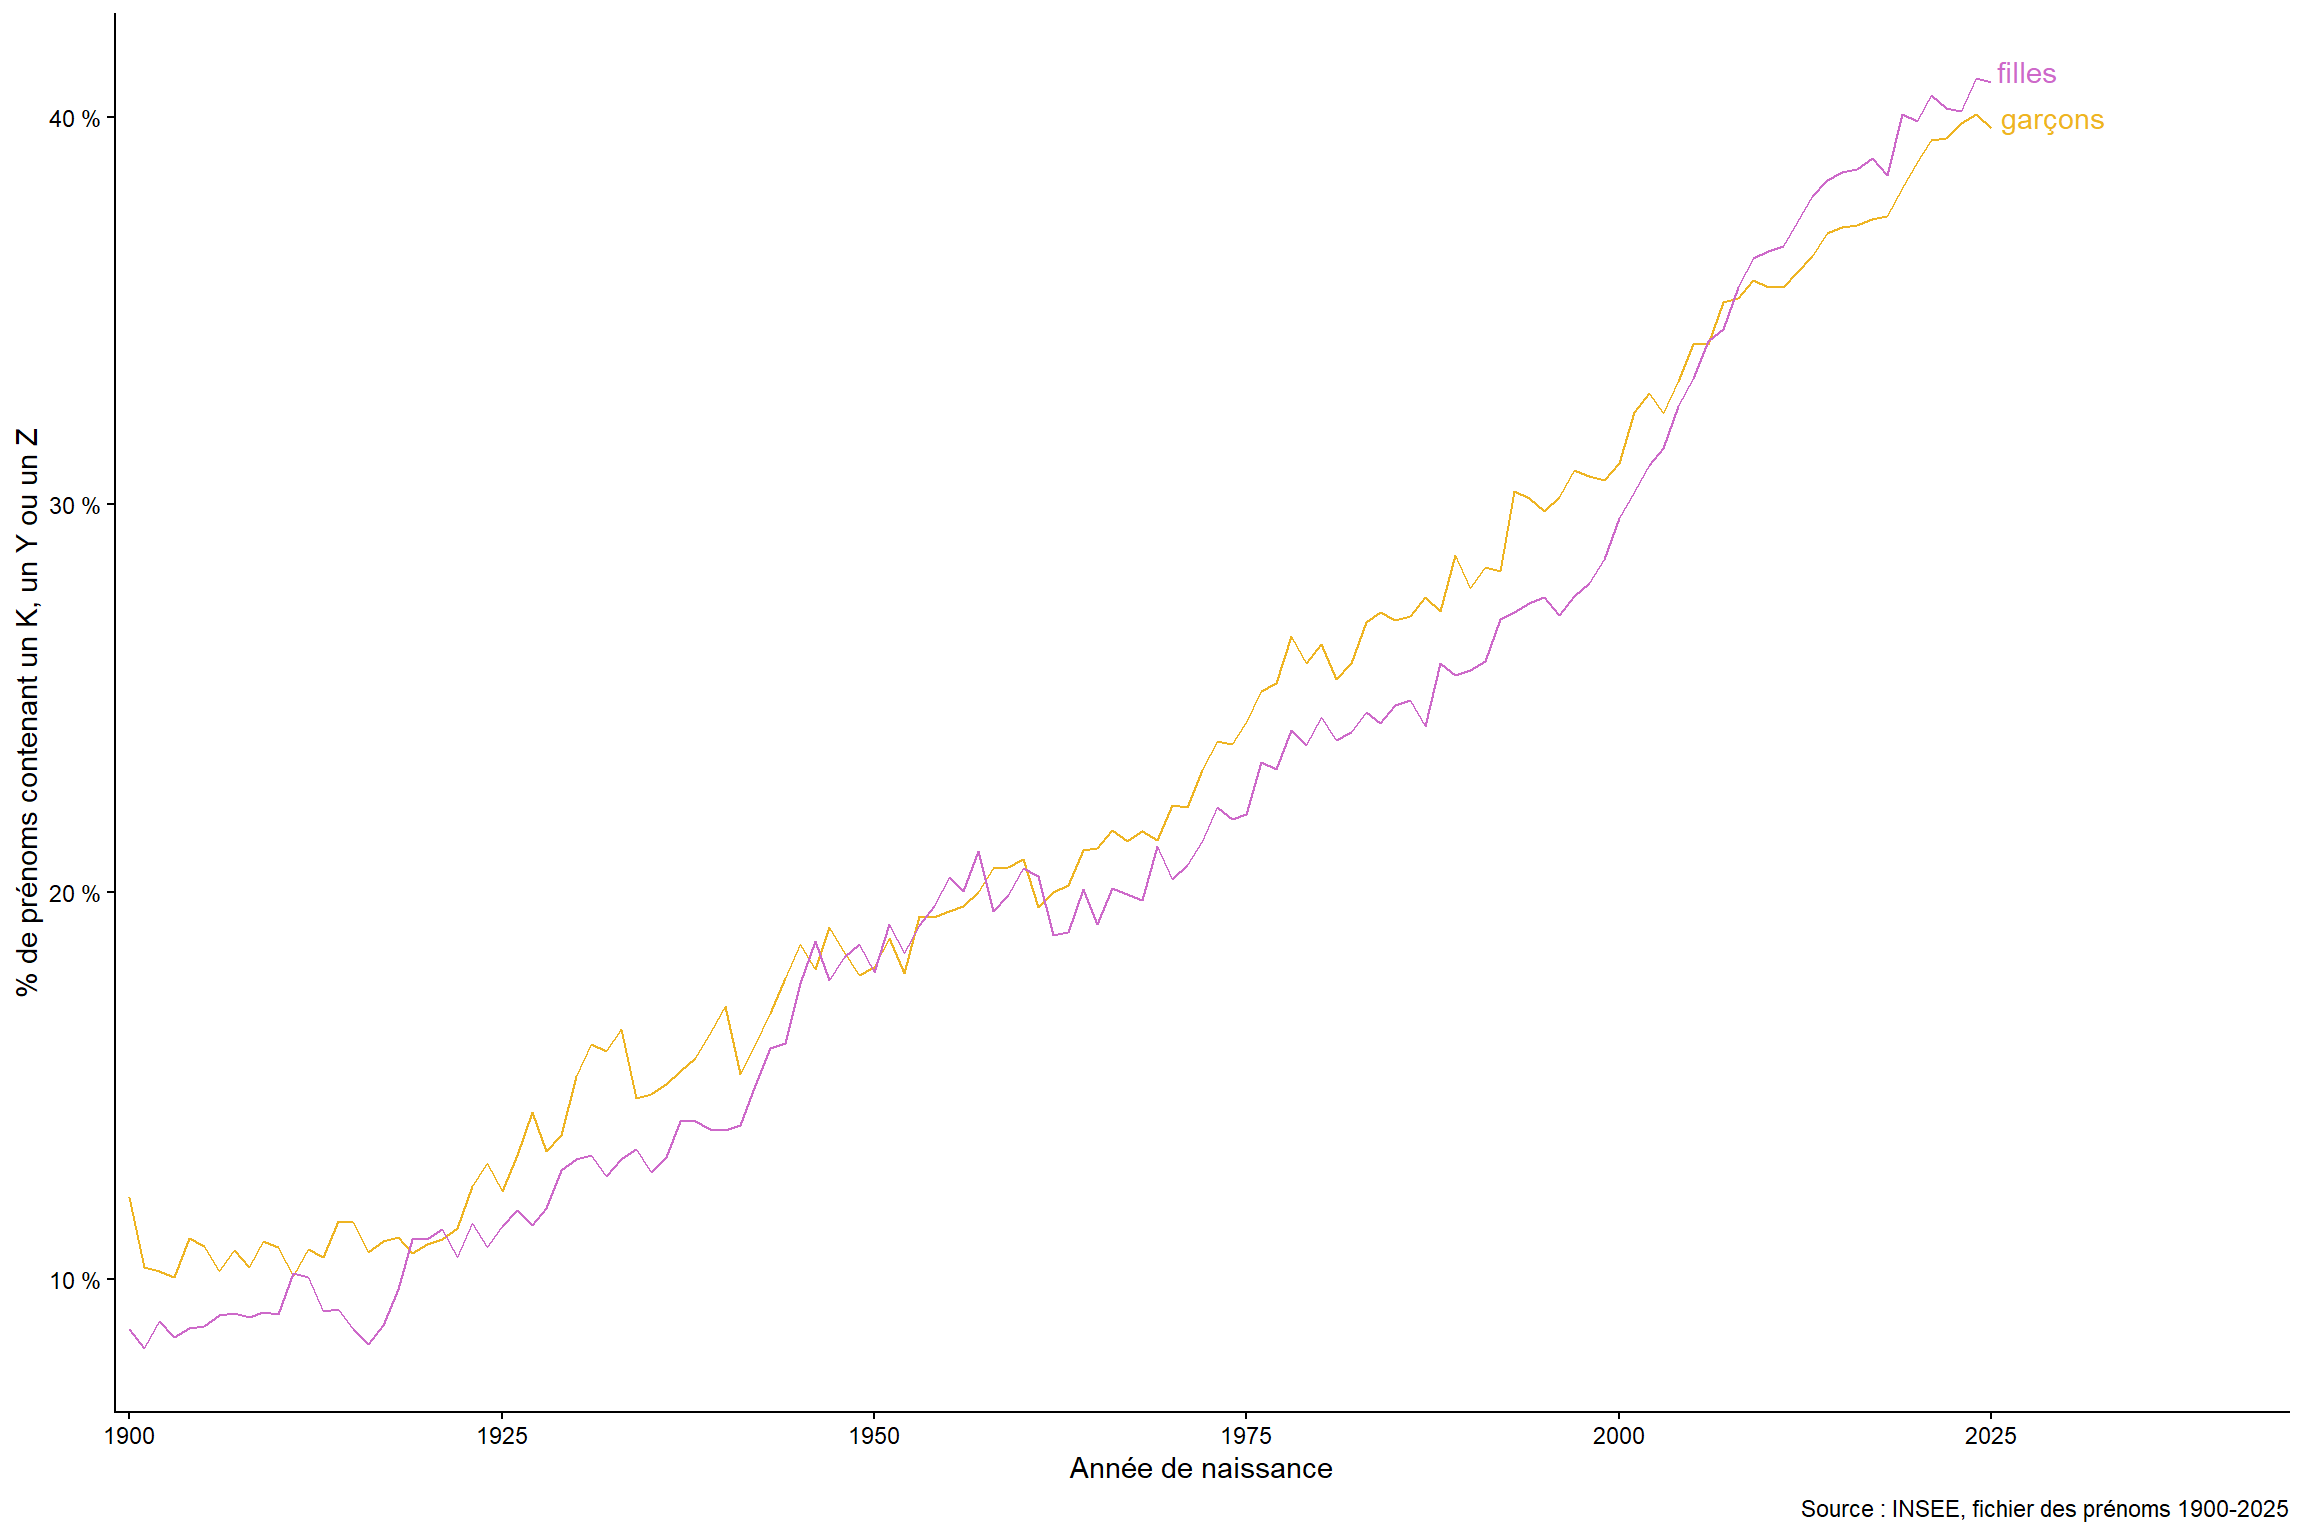
Le prénom Olivier
Je ne sais pas pourquoi mes parents ont choisi Olivier pour me prénommer, plutôt qu’autre chose. Donc je me suis demandé s’ils avaient juste suivi une mode.
On trouve facilement sur Internet des graphiques sur le nombre d’Olivier nés chaque année depuis 1900. Il y a effectivement eu un pic, une mode. Mais avec les données Insee on peut se poser des questions plus fines : est-ce qu’il y avait une mode locale en Charente-Maritime sur mon prénom, vers l’année de ma naissance, à la fin des années 1970 ?
La réponse avec ce spaghetti plot : c’est à dire un grand nombre de courbes (ici par département) de couleur uniforme et superposées, ainsi que les courbes qui nous intéressent (mon département de naissance et le cumul France entière) dans des couleurs qui tranchent.
olivier <- tbl(bd, "pre_tbl") %>%
  filter(periode %in% 1960:1990 &
           sexe == "1" &
           niveau_geographique == "DEP") %>%
  mutate(ol = ifelse(prenom == "OLIVIER", valeur, 0),
         annee = as.integer(periode)) %>%
  group_by(annee, geographie) %>%
  summarise(pct_ol = sum(ol)/sum(valeur) * 100) %>%
  ungroup() %>%
  collect()
`summarise()` has grouped output by "annee". You can override using the
`.groups` argument.
# France entière
olivier_fr <- tbl(bd, "pre_tbl") %>%
filter(periode %in% 1960:1990 &
sexe == "1" &
niveau_geographique == "FRANCE") %>%
mutate(ol = ifelse(prenom == "OLIVIER", valeur, 0),
annee = as.integer(periode)) %>%
group_by(annee, geographie) %>%
summarise(pct_ol = sum(ol)/sum(valeur) * 100) %>%
ungroup() %>%
collect()
`summarise()` has grouped output by "annee". You can override using the
`.groups` argument.ggplot(olivier) +
aes(x = annee, y = pct_ol, group=geographie) +
geom_vline(colour=gray(0.4), xintercept = 1977, lty=2) +
geom_line(colour="gray", alpha=0.3) +
geom_line(colour="coral", lwd=2,
data=olivier_fr) +
geom_line(colour="blue", lwd=2,
data=olivier %>% filter(geographie=="17")) +
theme_classic() +
scale_y_continuous(labels = ~ paste(.x, "%"),
expand = expansion(0)) +
scale_x_continuous(expand = expansion(add=c(0,0.5))) +
labs(x="Année de naissance",
y="% de naissances avec le prénom Olivier",
caption="Source : INSEE, fichier des prénoms 1960-1990",
title="% de naissances de garçons avec le prénom **Olivier**",
subtitle="<span style='color:coral'>France entière</span> et <span style='color:blue'>Charente-Maritime</span>") +
theme(plot.title = element_markdown(),
plot.subtitle = element_markdown())
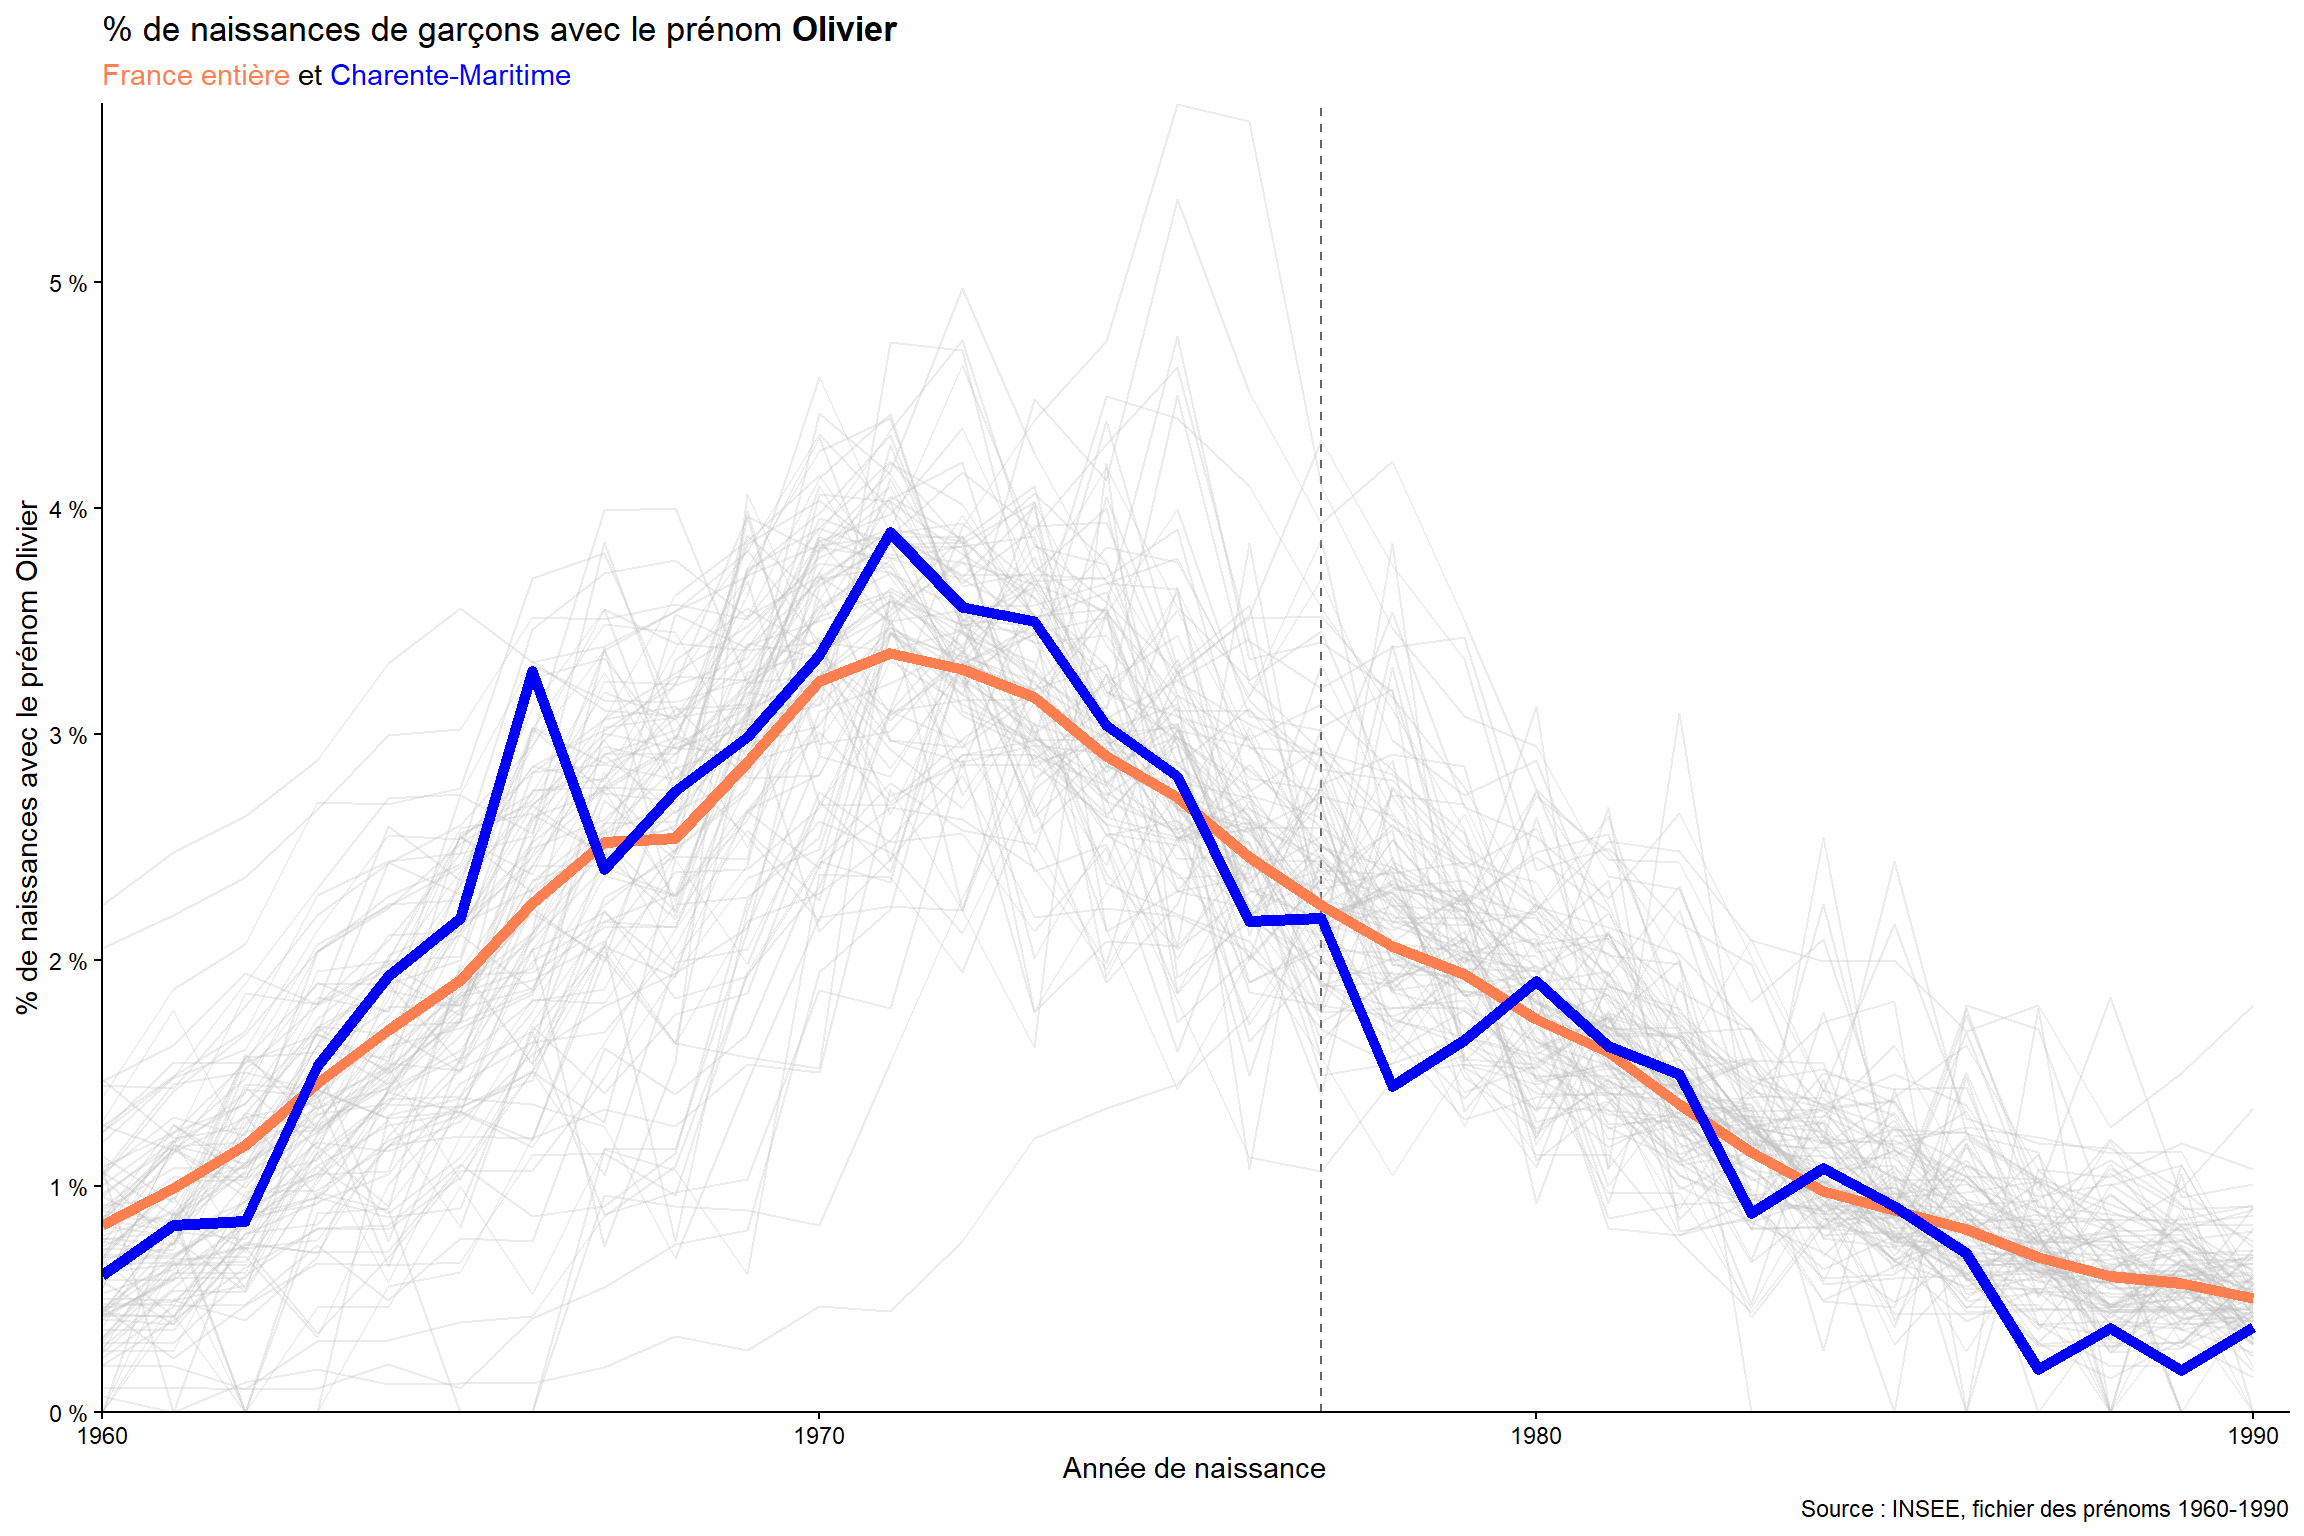
Il y a bien eu une mode, en Charente-Maritime en même temps que sur le reste de la France, mais mes parents ne l’ont suivi que presque 10 ans plus tard. C’est bien de prendre le temps du recul devant des nouveautés. 😃
Top 5 cumulatifs
Chaque année l’Insee publie les top 5 des prénoms donnés l’année précédente. Au niveau national, régional, départemental. Mais je n’ai pas souvenir d’avoir vu ces top 5 sur des périodes de temps plus longues. Pourquoi pas un cumul 1900-2025 ?
Cumuls 1900-2025
cumuls <- tbl(bd, "pre_tbl") %>%
  filter(niveau_geographique == "FRANCE") %>%
  group_by(sexe, prenom) %>%
  summarise(tot = sum(valeur, na.rm = TRUE)) %>%
  ungroup() %>%
  collect()
`summarise()` has grouped output by "sexe". You can override using the
`.groups` argument.
# filles
top5_filles <- cumuls %>%
filter(sexe == "2") %>%
arrange(desc(tot)) %>%
slice_head(n=5)
# garçons
top5_garcons <- cumuls %>%
filter(sexe == "1") %>%
arrange(desc(tot)) %>%
slice_head(n=5)
# prénoms épicènes (la proportion d'un sexe dans le total est entre 1/4 et 3/4)
top5_epicene <- cumuls %>%
pivot_wider(id_cols = prenom,
names_from = sexe,
names_prefix = "sexe_",
values_from = tot) %>%
mutate(tot = sexe_1 + sexe_2) %>%
filter(! is.na(tot)) %>%
filter( (sexe_1/tot) %>% between(0.25, 0.75)) %>%
arrange(desc(tot)) %>%
slice_head(n=5) %>%
select(- tot) %>%
pivot_longer(cols = -prenom,
names_prefix = "sexe_",
names_to = "sexe",
values_to = "tot") %>%
mutate(prenom = forcats::as_factor(prenom))
# prénoms composés (= contenant un tiret)
top5_compose <- cumuls %>%
filter(grepl("-", prenom)) %>%
arrange(desc(tot)) %>%
slice_head(n=5)
Là j’ai fait un effort avec une petite fonction pour éviter de trop répéter mon code.
options(scipen = 999)
top5_plot <- function(data, titre=NULL, titre2=NULL, bdp=""){
  ggplot(data) +
    aes(y=forcats::fct_rev(forcats::as_factor(prenom)),
        x=tot,
        fill=sexe) +
    geom_col(colour="black", show.legend = FALSE) +
    theme_classic() +
    scale_fill_manual(values=palette) +
    scale_x_continuous(labels = ~ prettyNum(.x, big.mark = " "),
                       expand = expansion(add=0)) +
    labs(x = "\nNombre de naissances cumulé 1900-2025\n",
         y = NULL,
         caption = paste(bdp,
                         "Source : INSEE, fichier des prénoms 1900-2025",
                         sep="\n\n"),
         title = titre,
         subtitle = titre2) +
    theme(plot.title = element_markdown(),
          plot.subtitle = element_markdown(),
          axis.ticks.length.y = unit(0,"mm"))
}
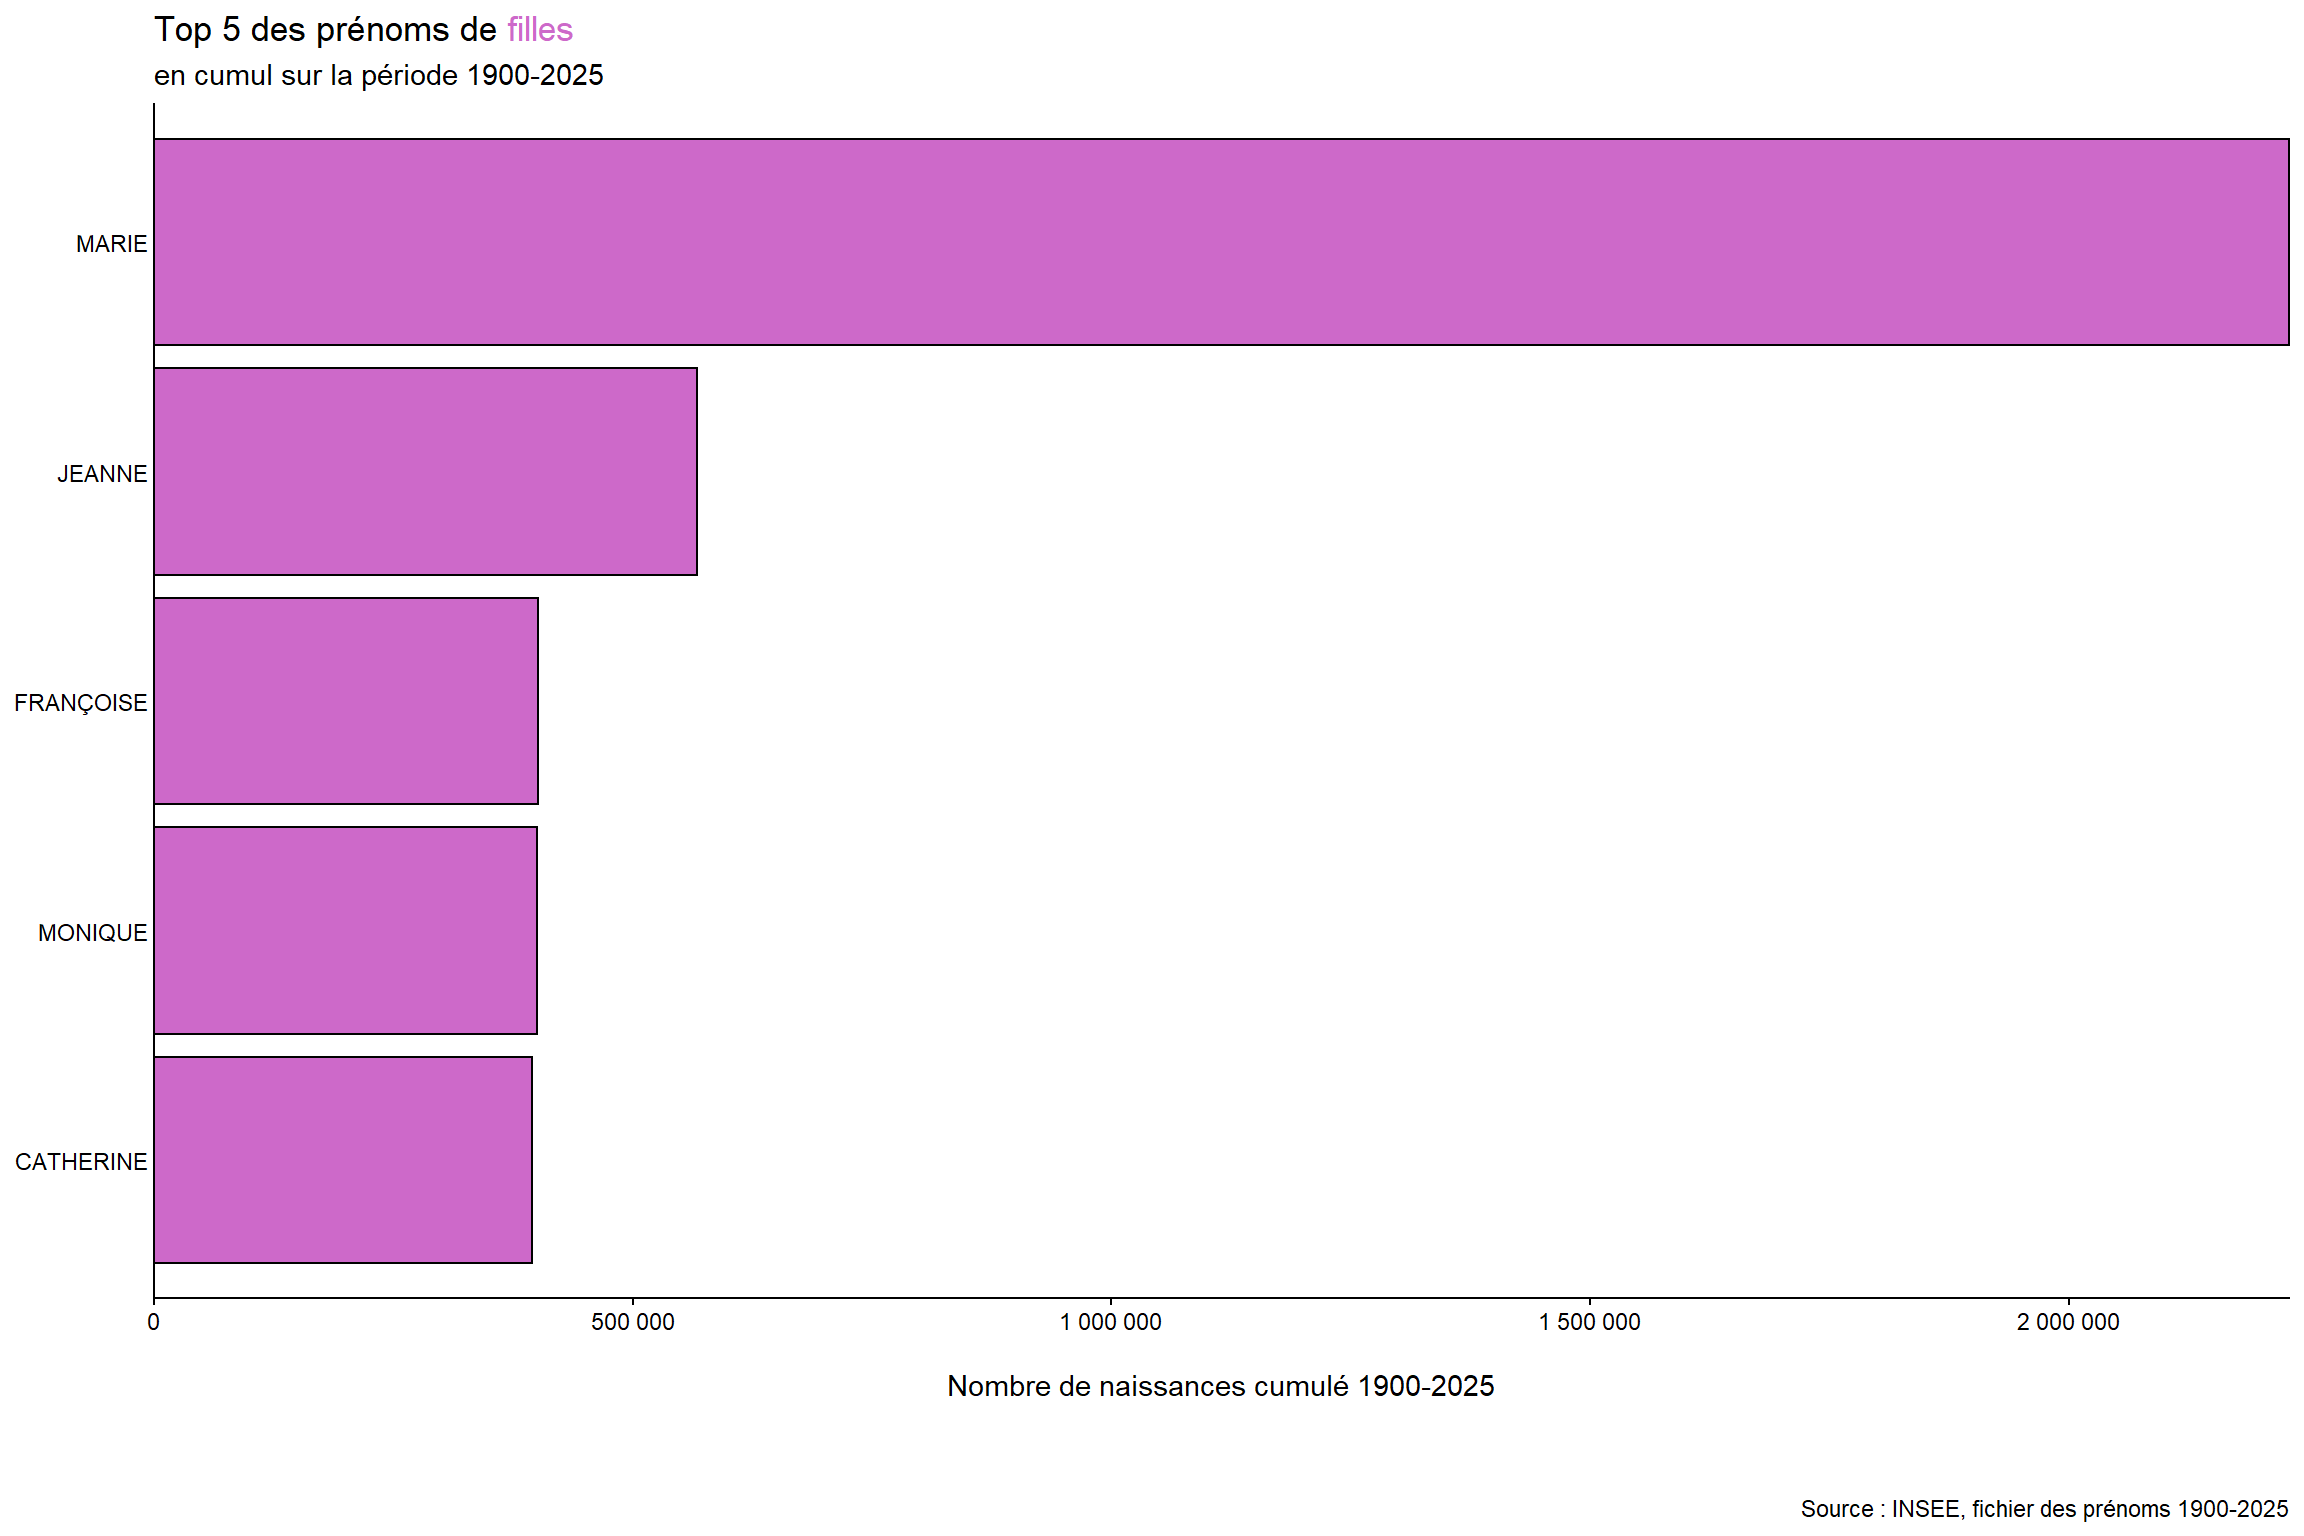
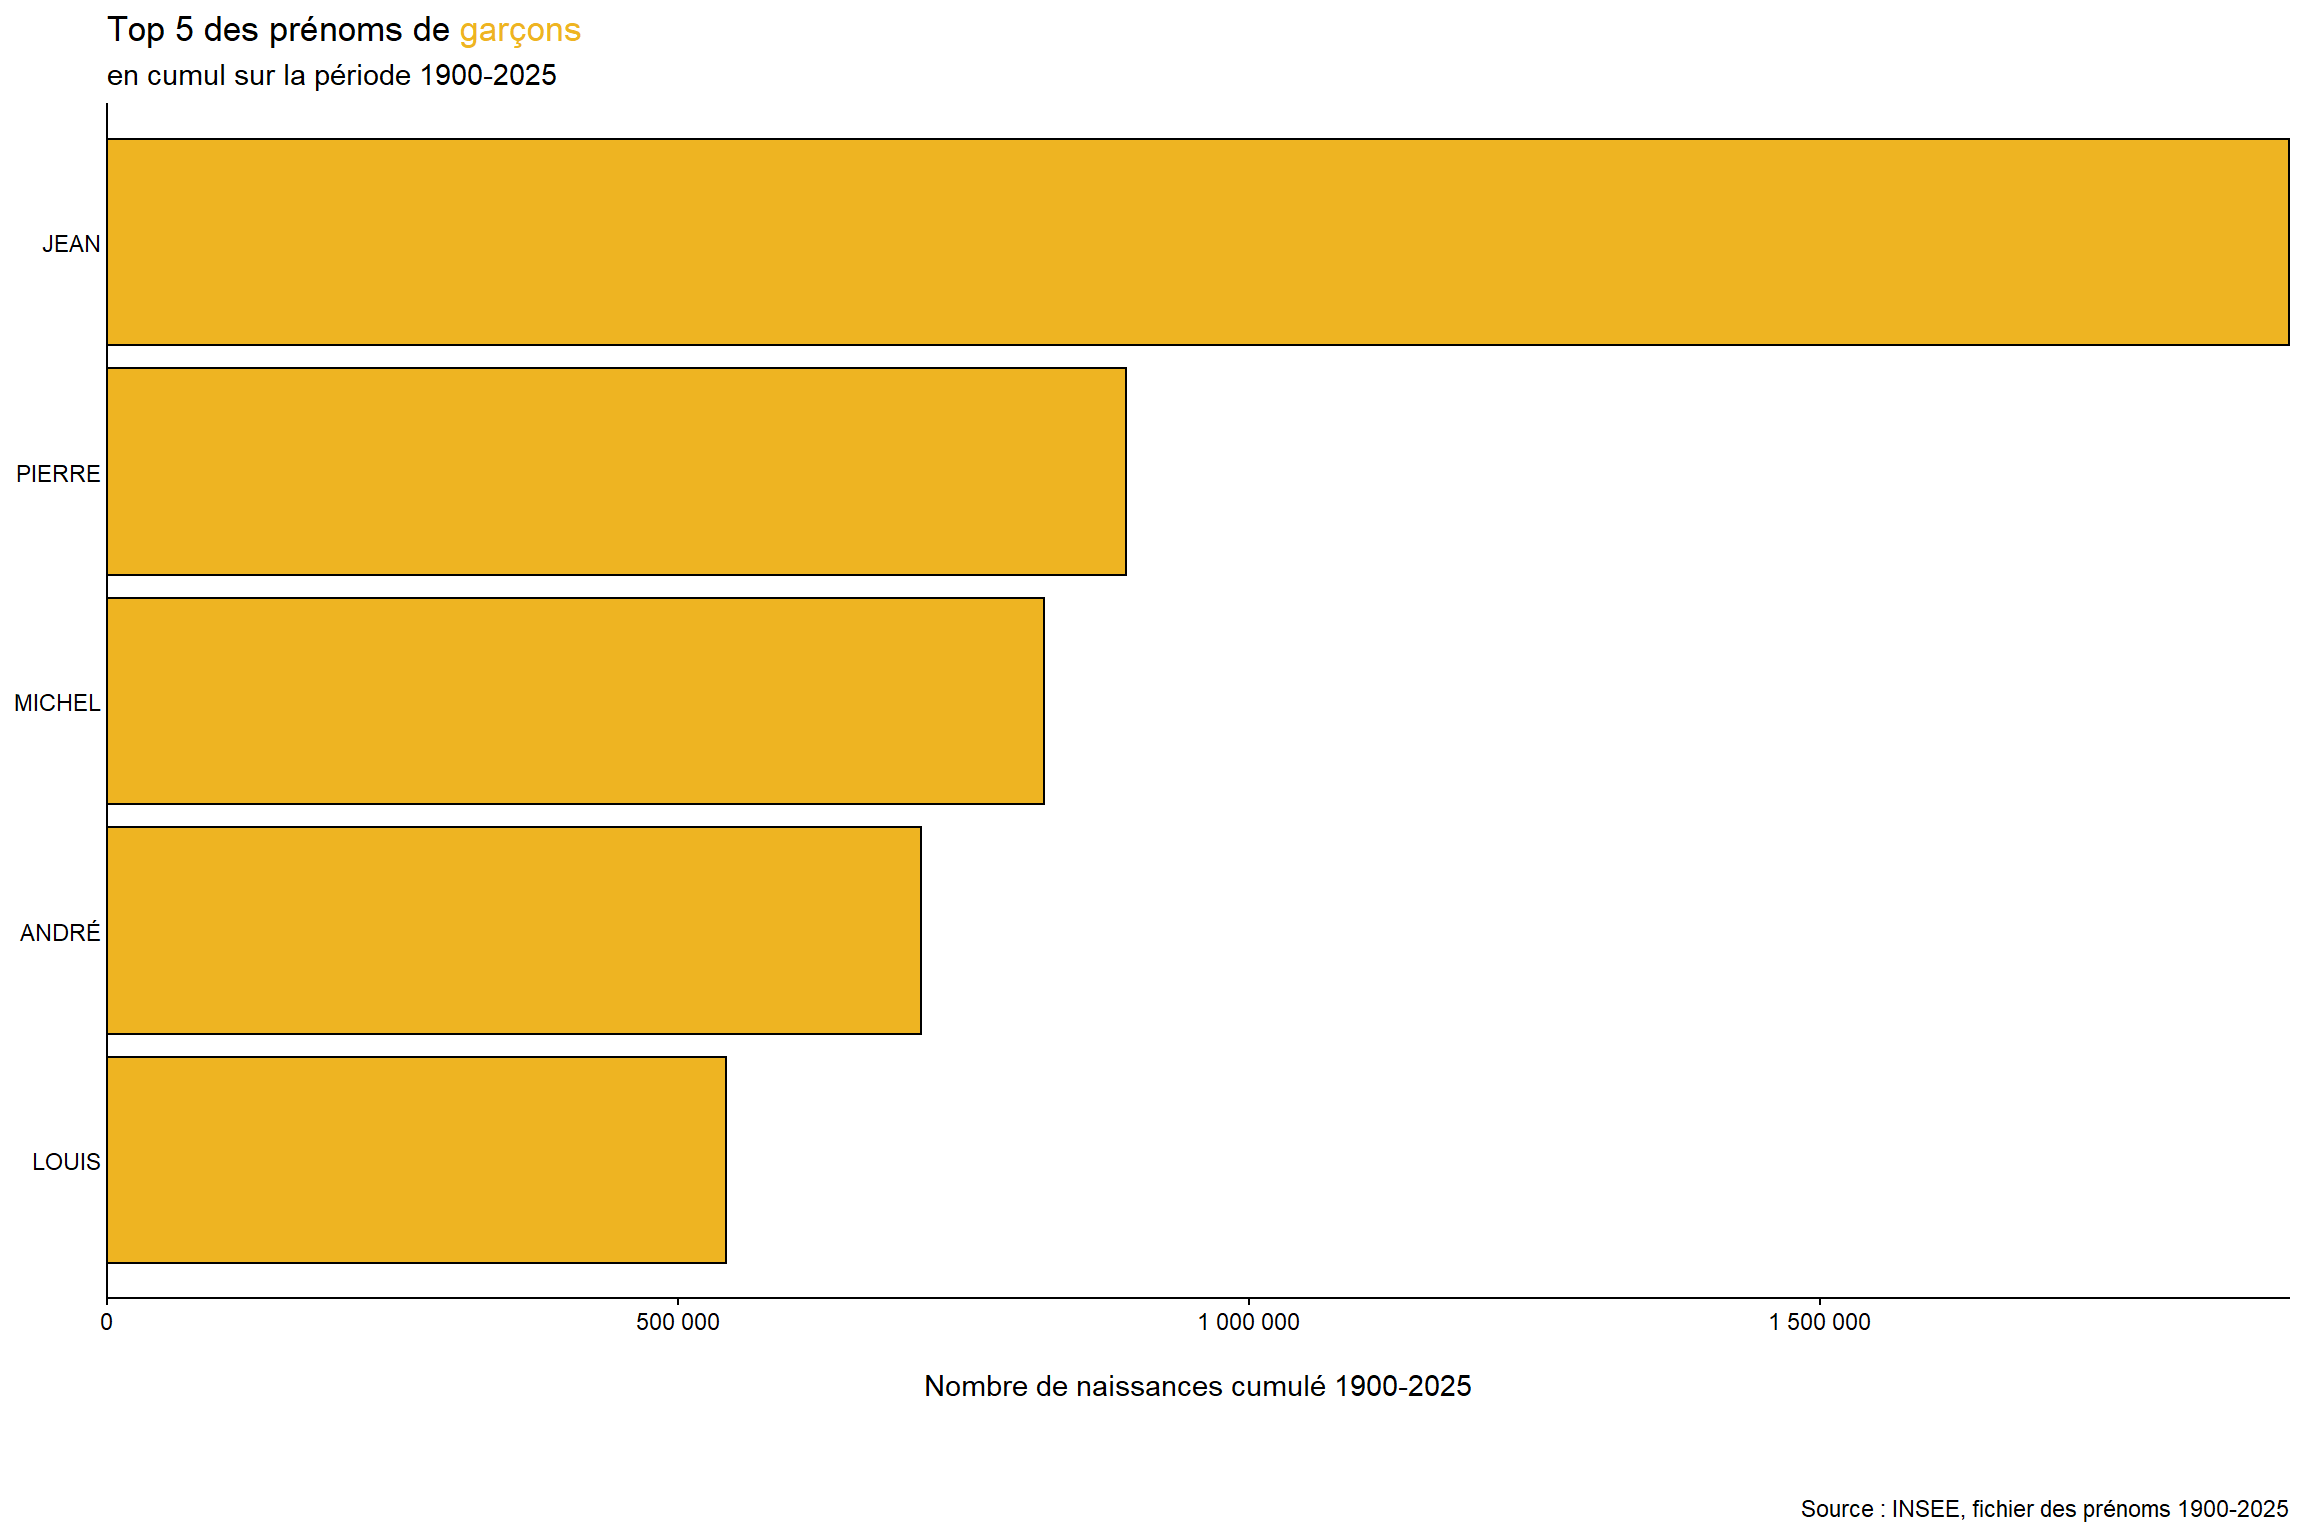
On peut facilement produire 4 graphiques homogènes : pour les prénoms des filles, ceux des garçons, pour les prénoms épicènes et pour les prénoms composés.
top5_plot(data=top5_filles ,
          titre="Top 5 des prénoms de <span style='color:orchid3'>filles</span>",
          titre2 = "en cumul sur la période 1900-2025")
top5_plot(data=top5_garcons,
          titre="Top 5 des prénoms de <span style='color:goldenrod2'>garçons</span>",
          titre2 = "en cumul sur la période 1900-2025")
top5_plot(data=top5_compose,
          titre="Top 5 des prénoms composés¹",
          titre2 = "en cumul sur la période 1900-2025",
          bdp="¹ qui contiennent un tiret")
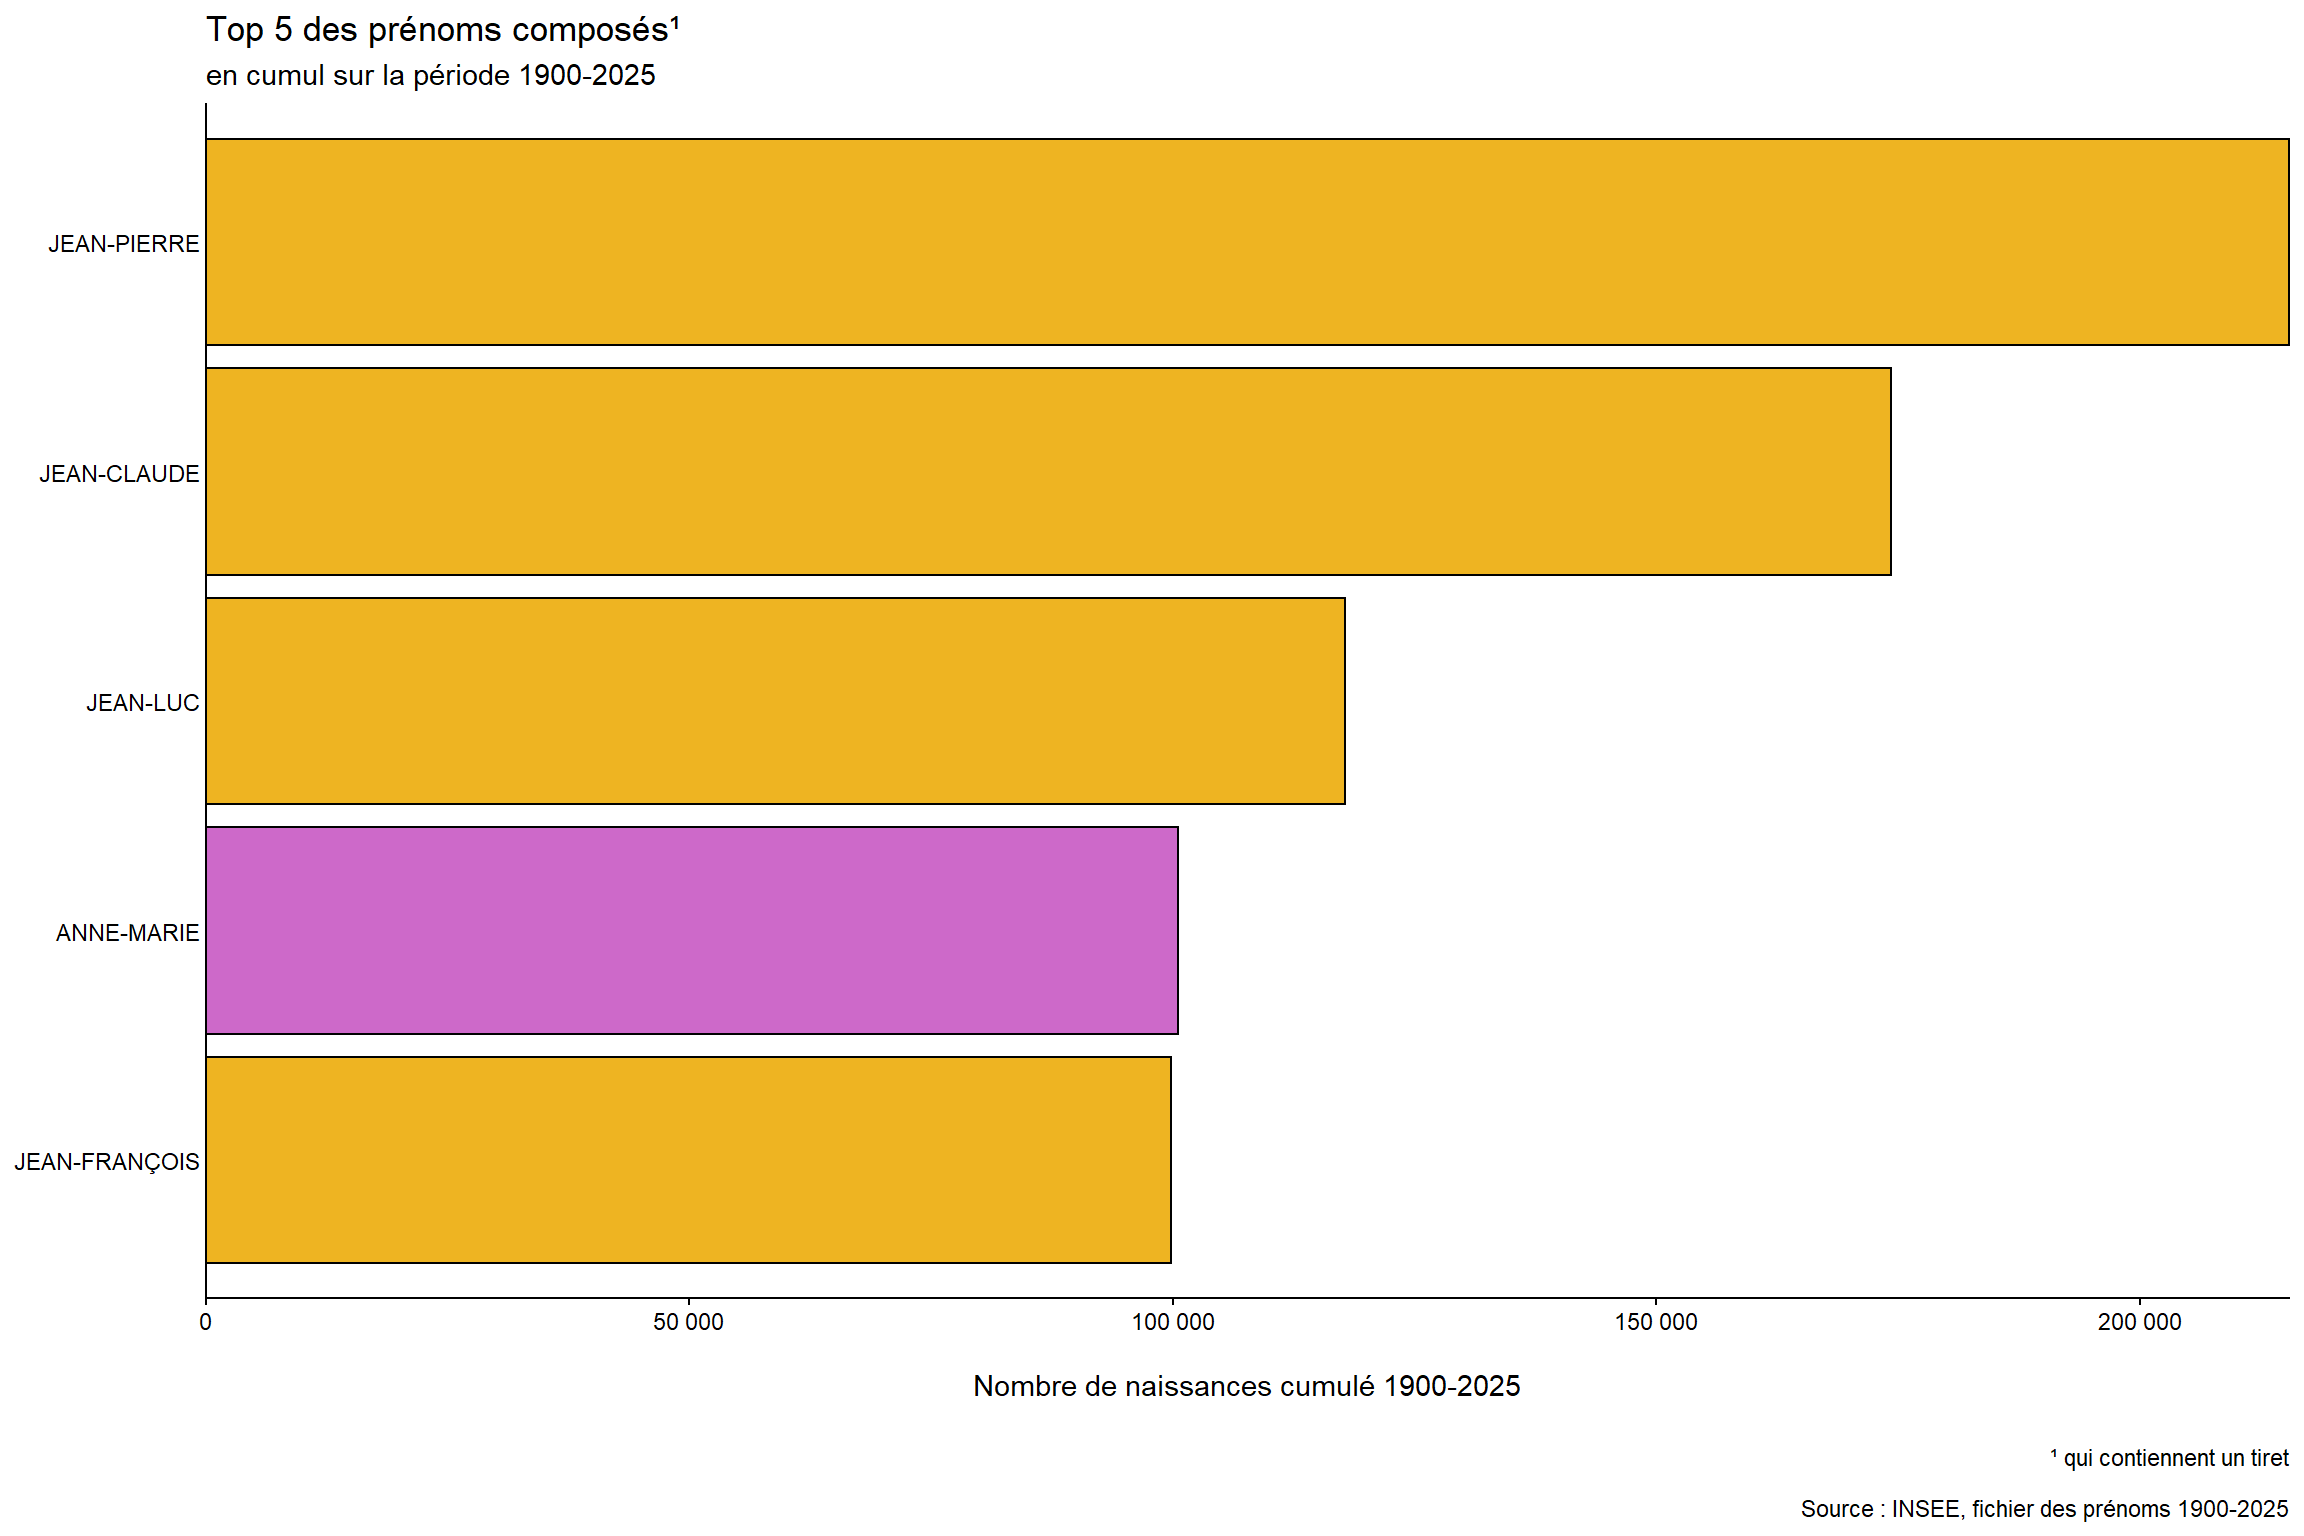
top5_plot(data=top5_epicene,
          titre="Top 5 des prénoms épicènes¹",
          titre2 = "en cumul sur la période 1900-2025",
          bdp="¹ où le sexe le moins fréquent pour ce prénom compte pour au moins ¼ du total")
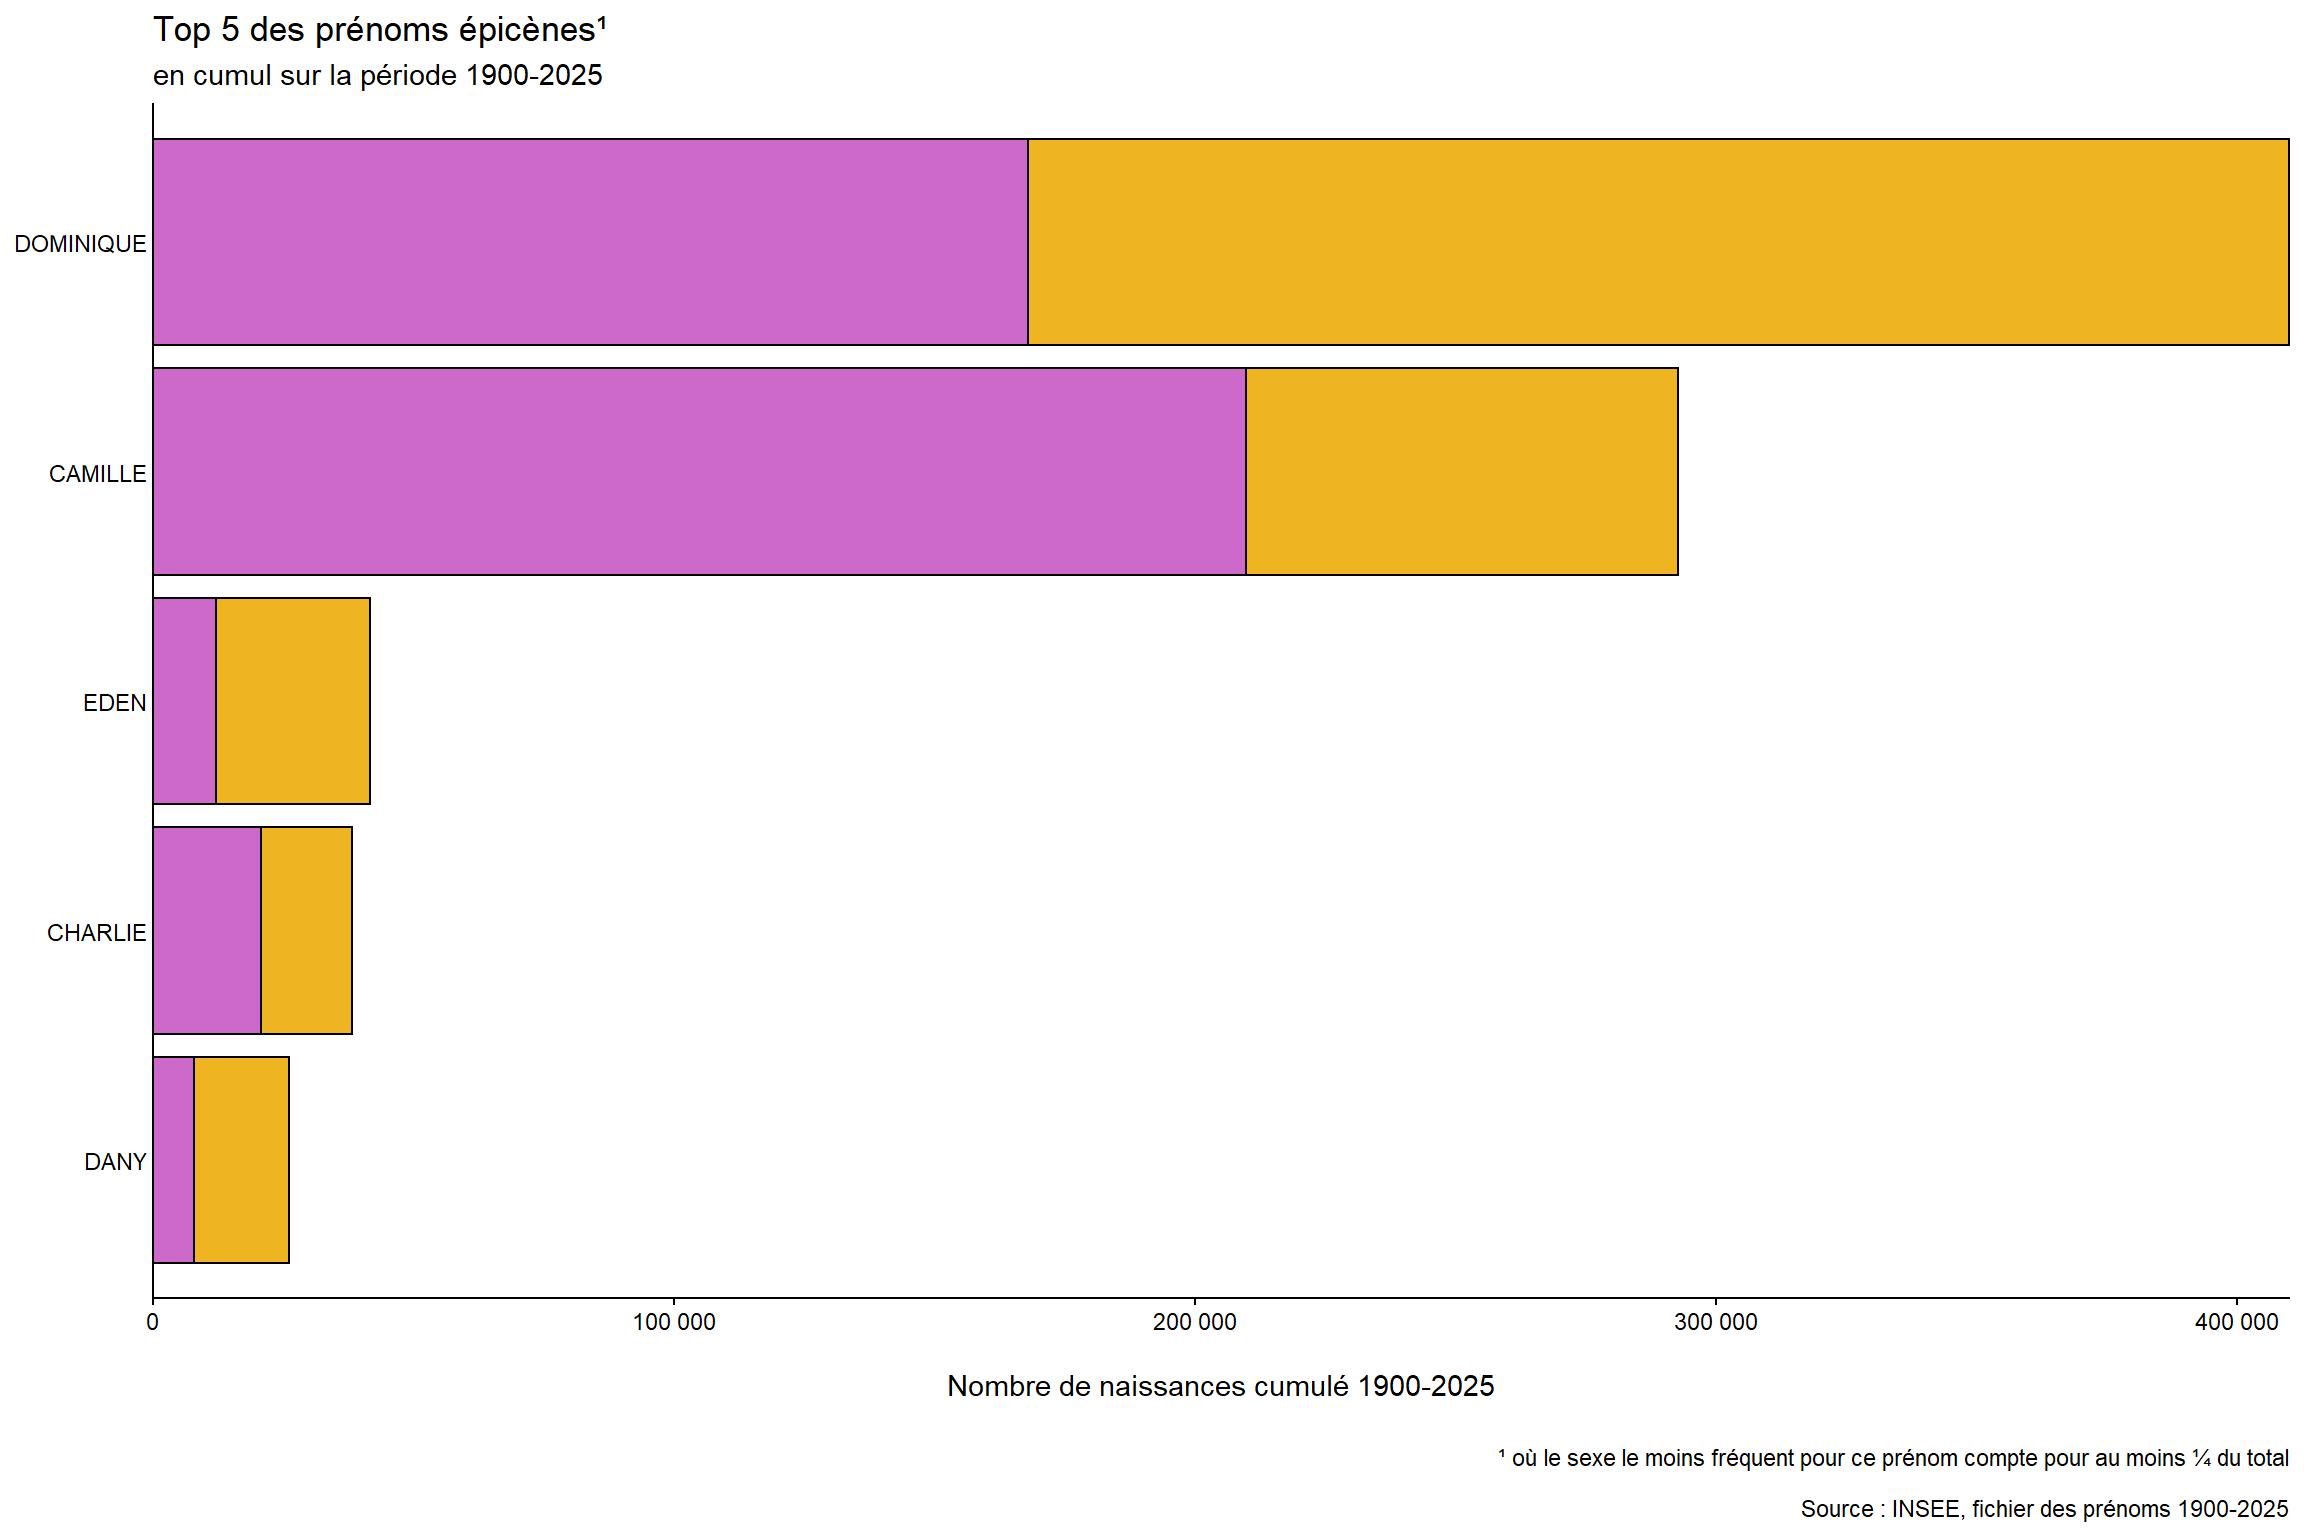
Cumuls par génération
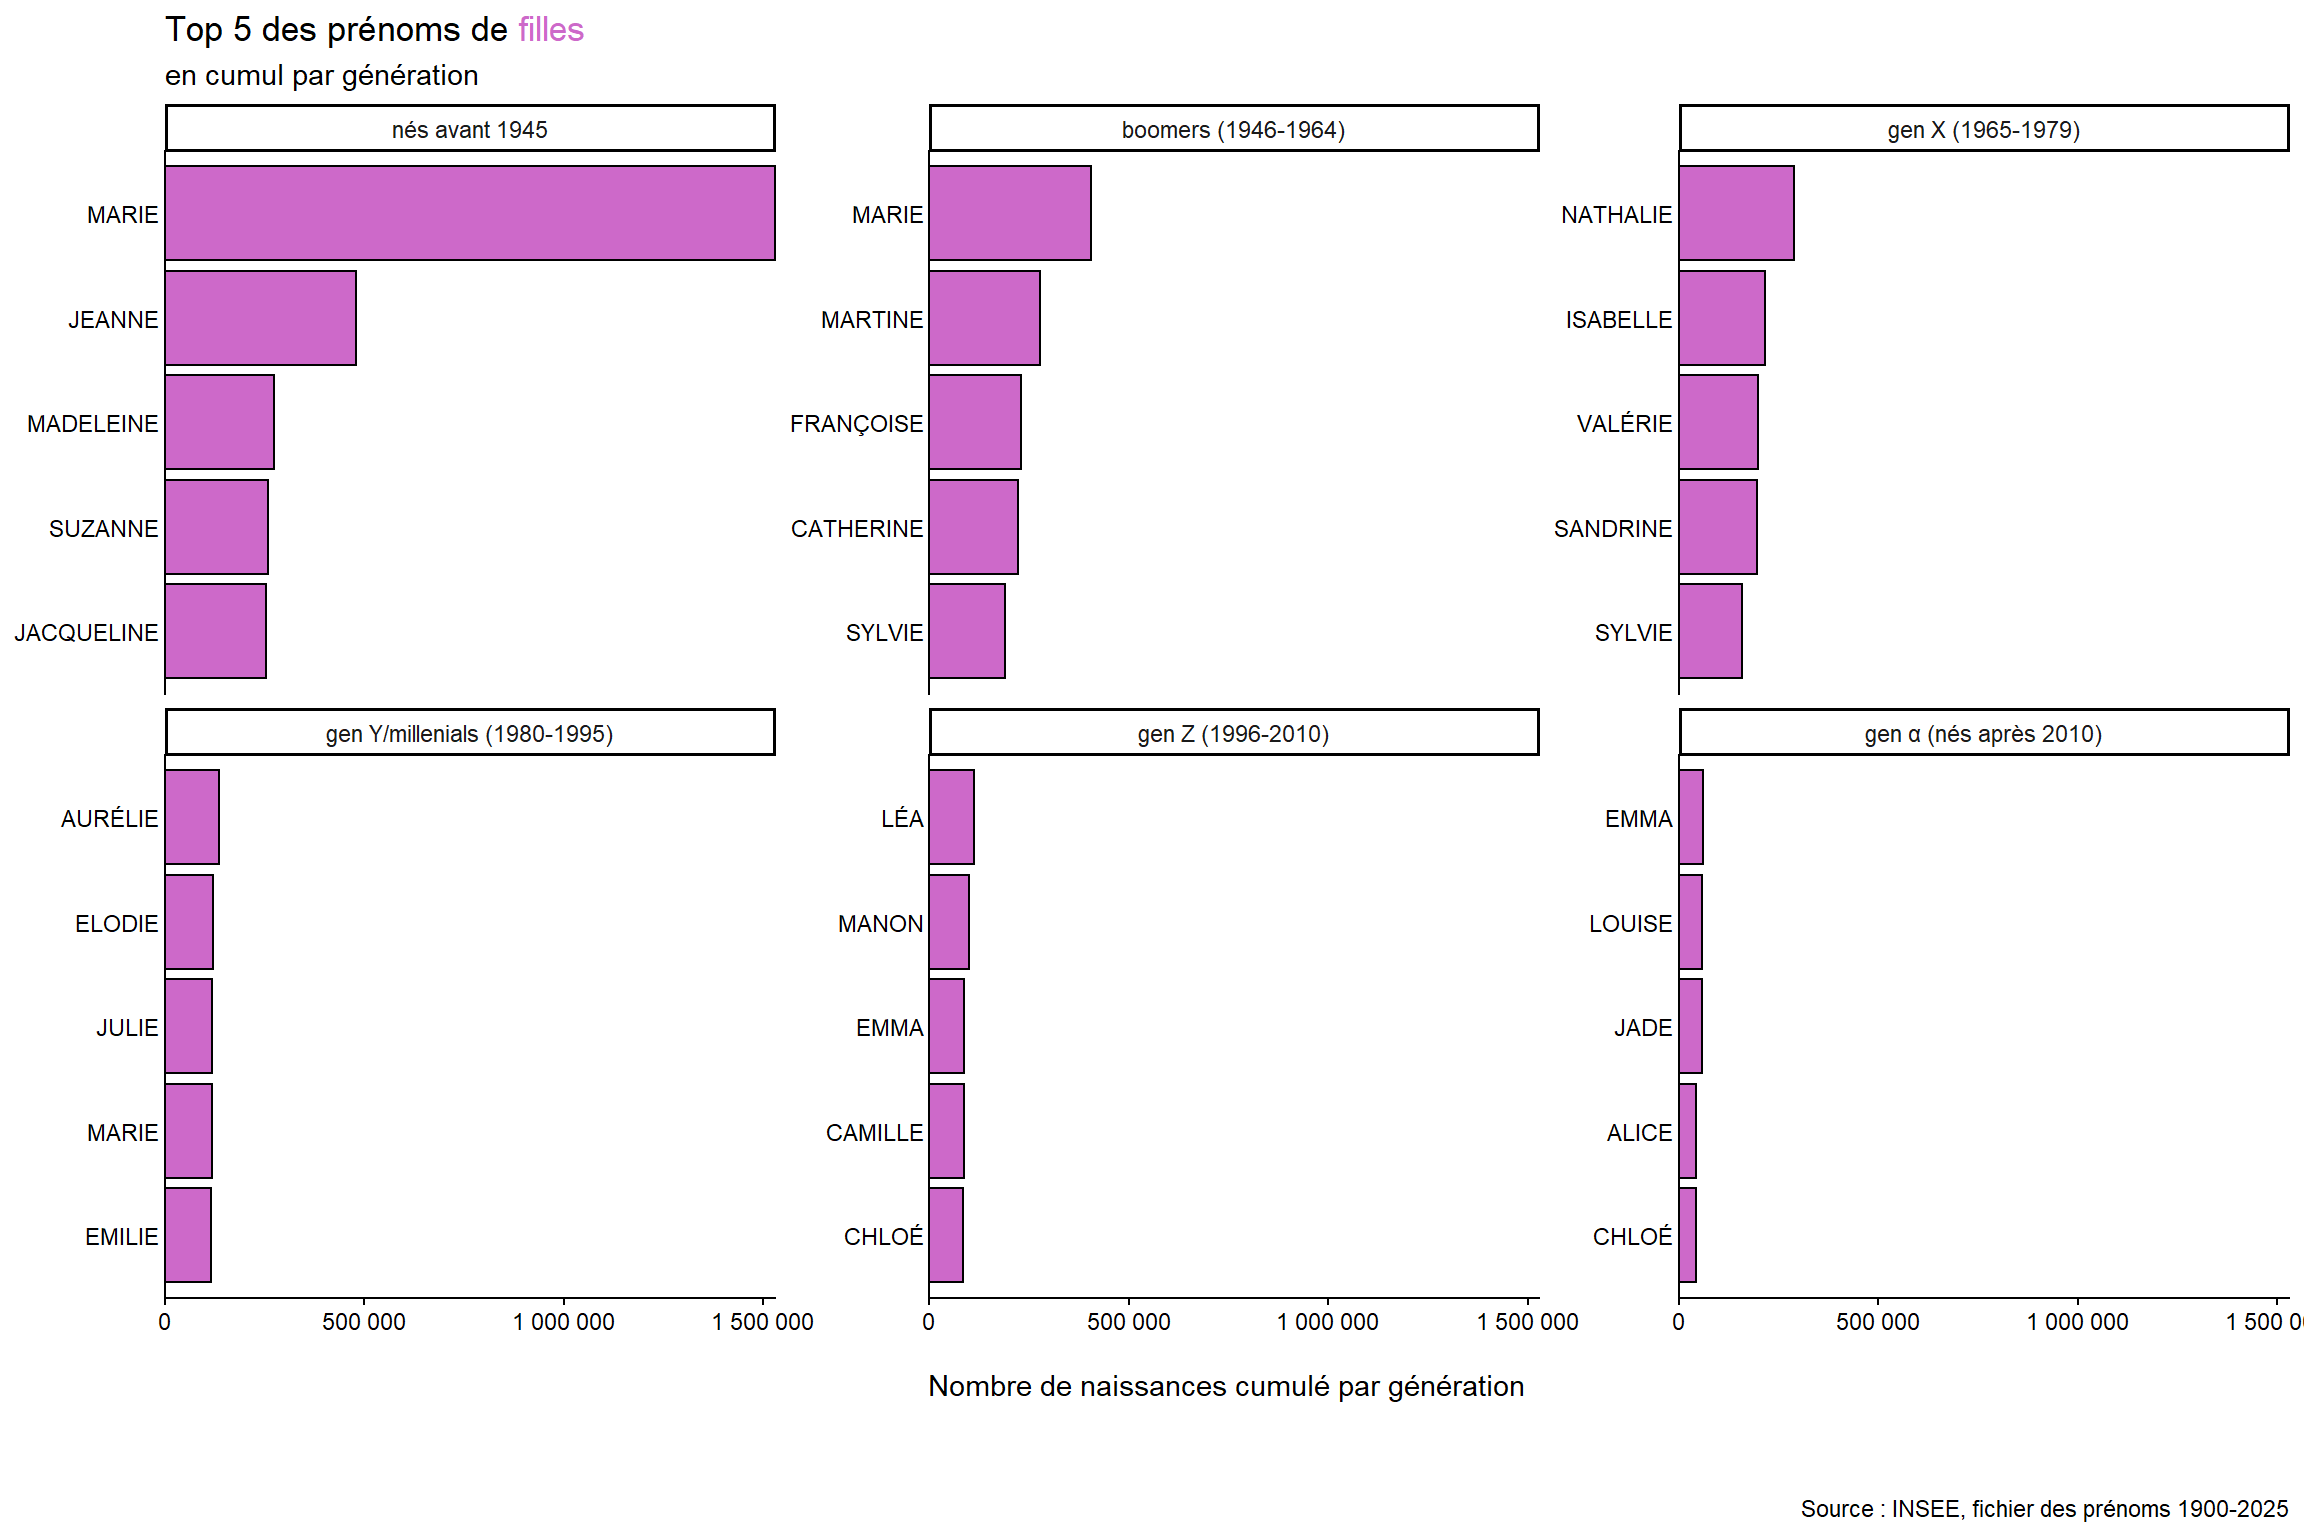
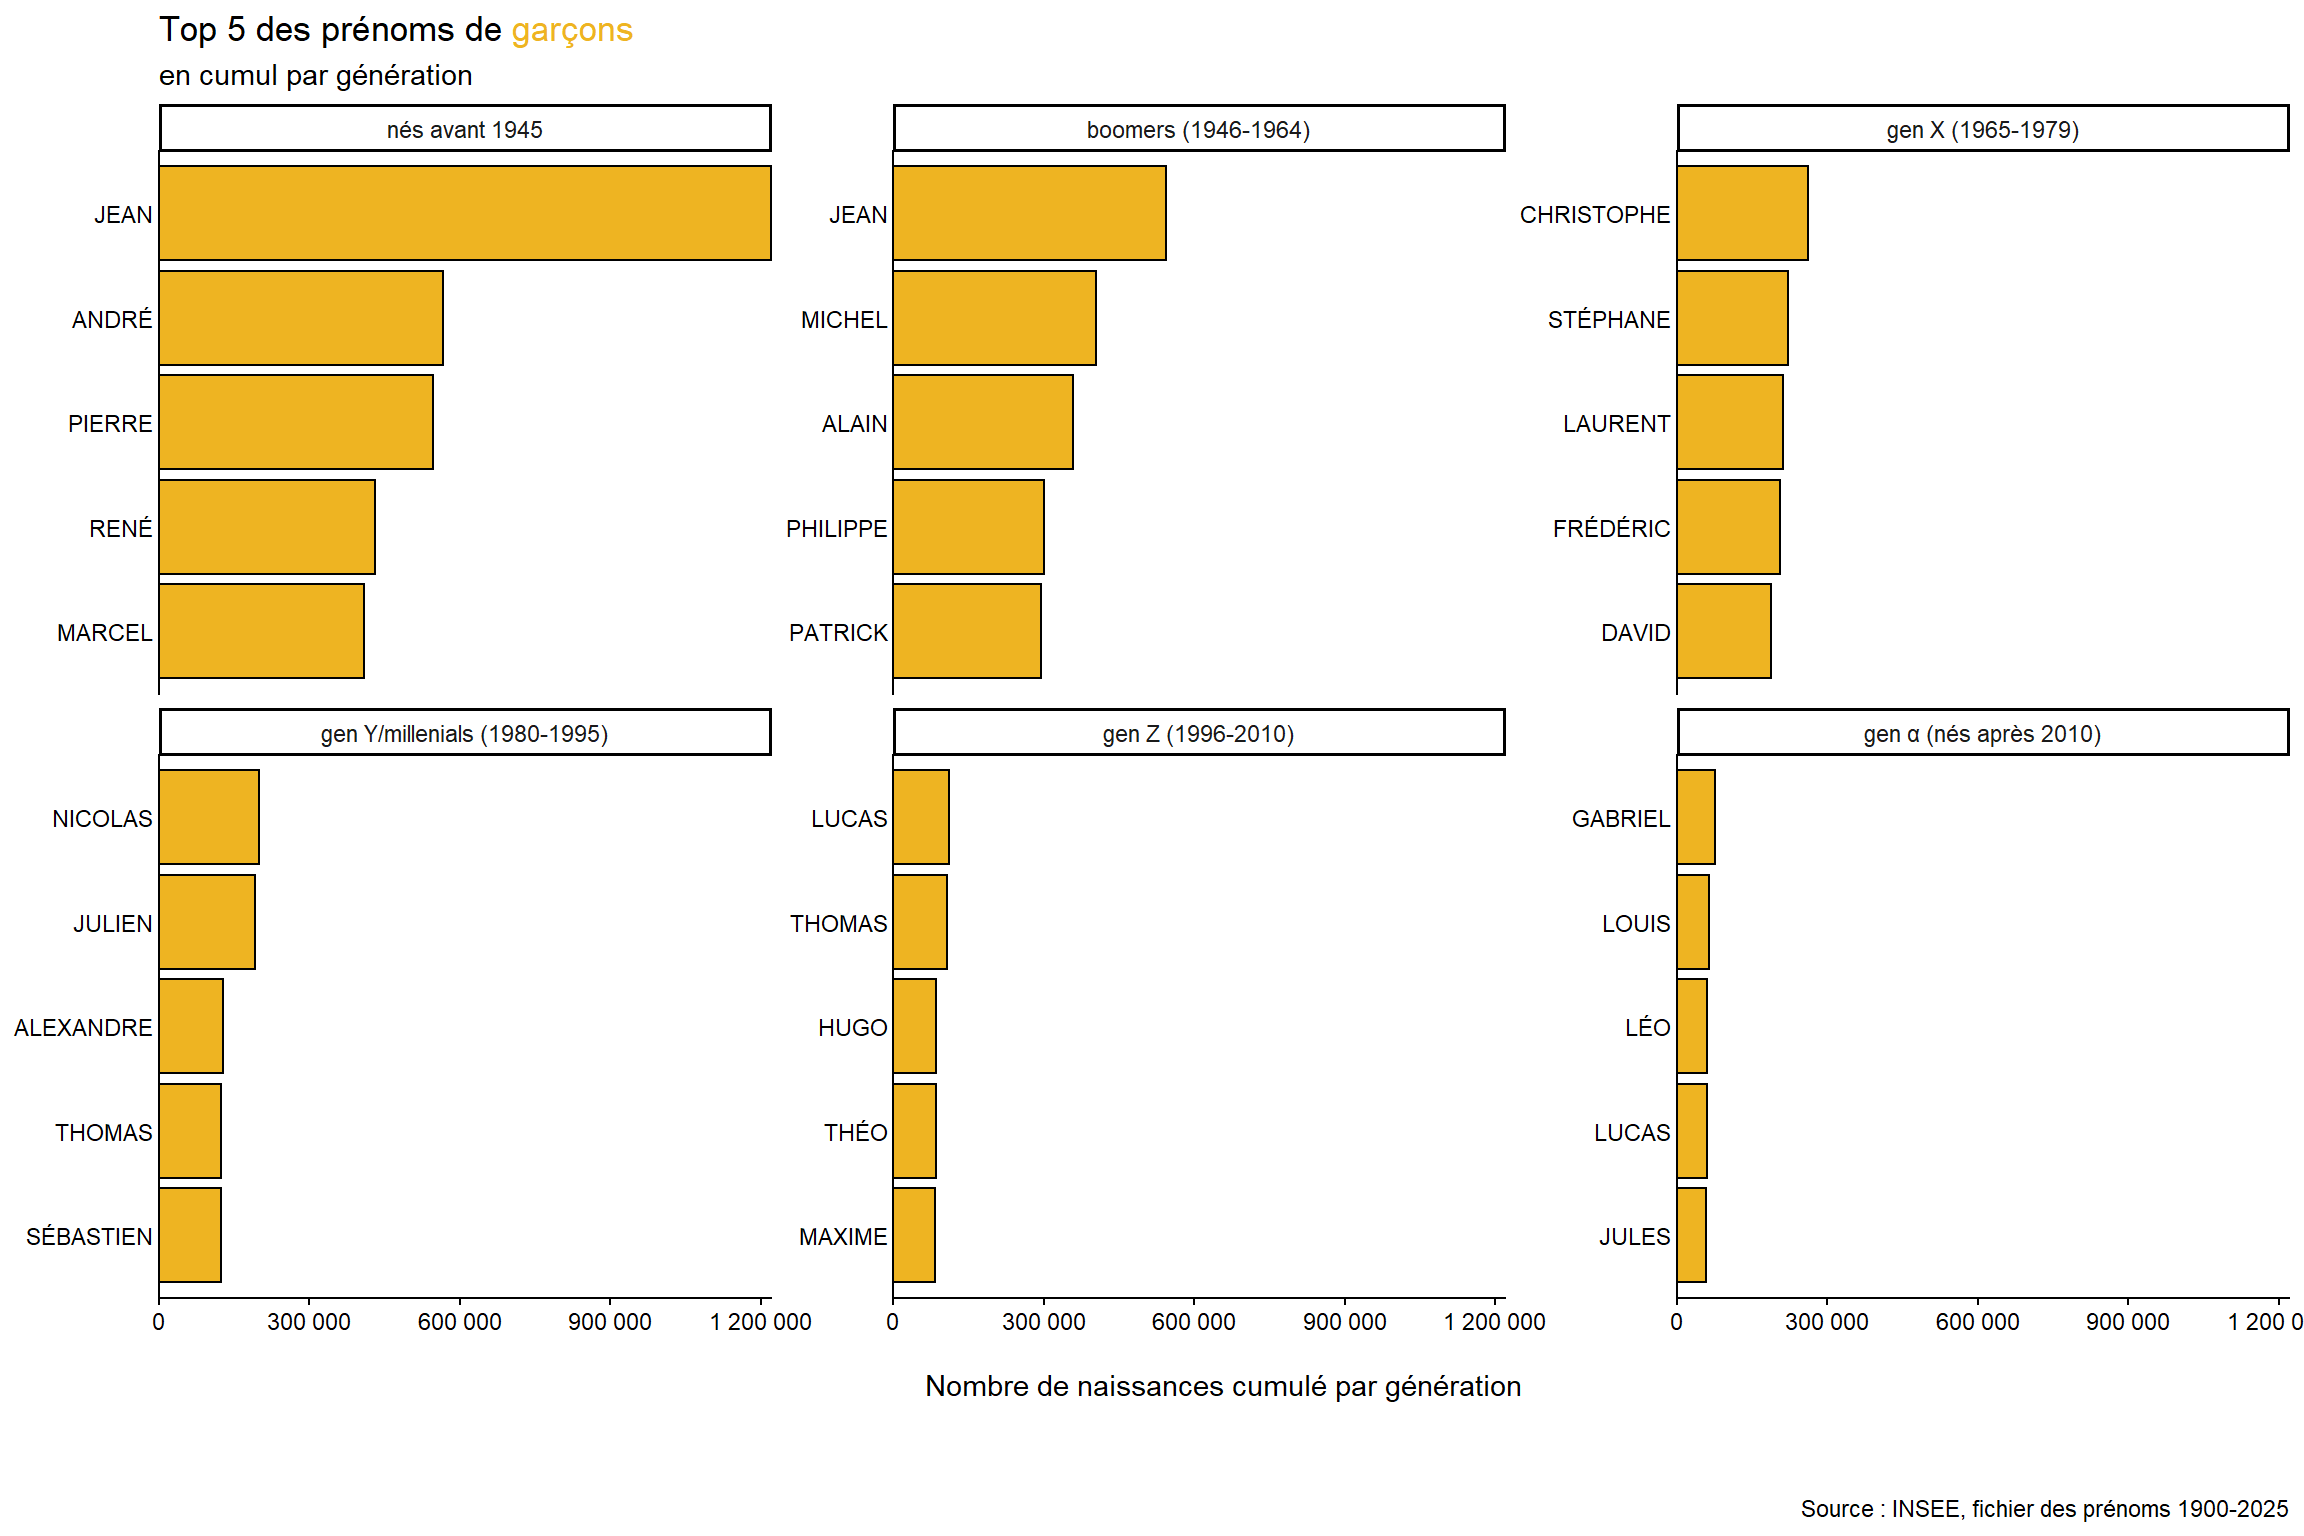
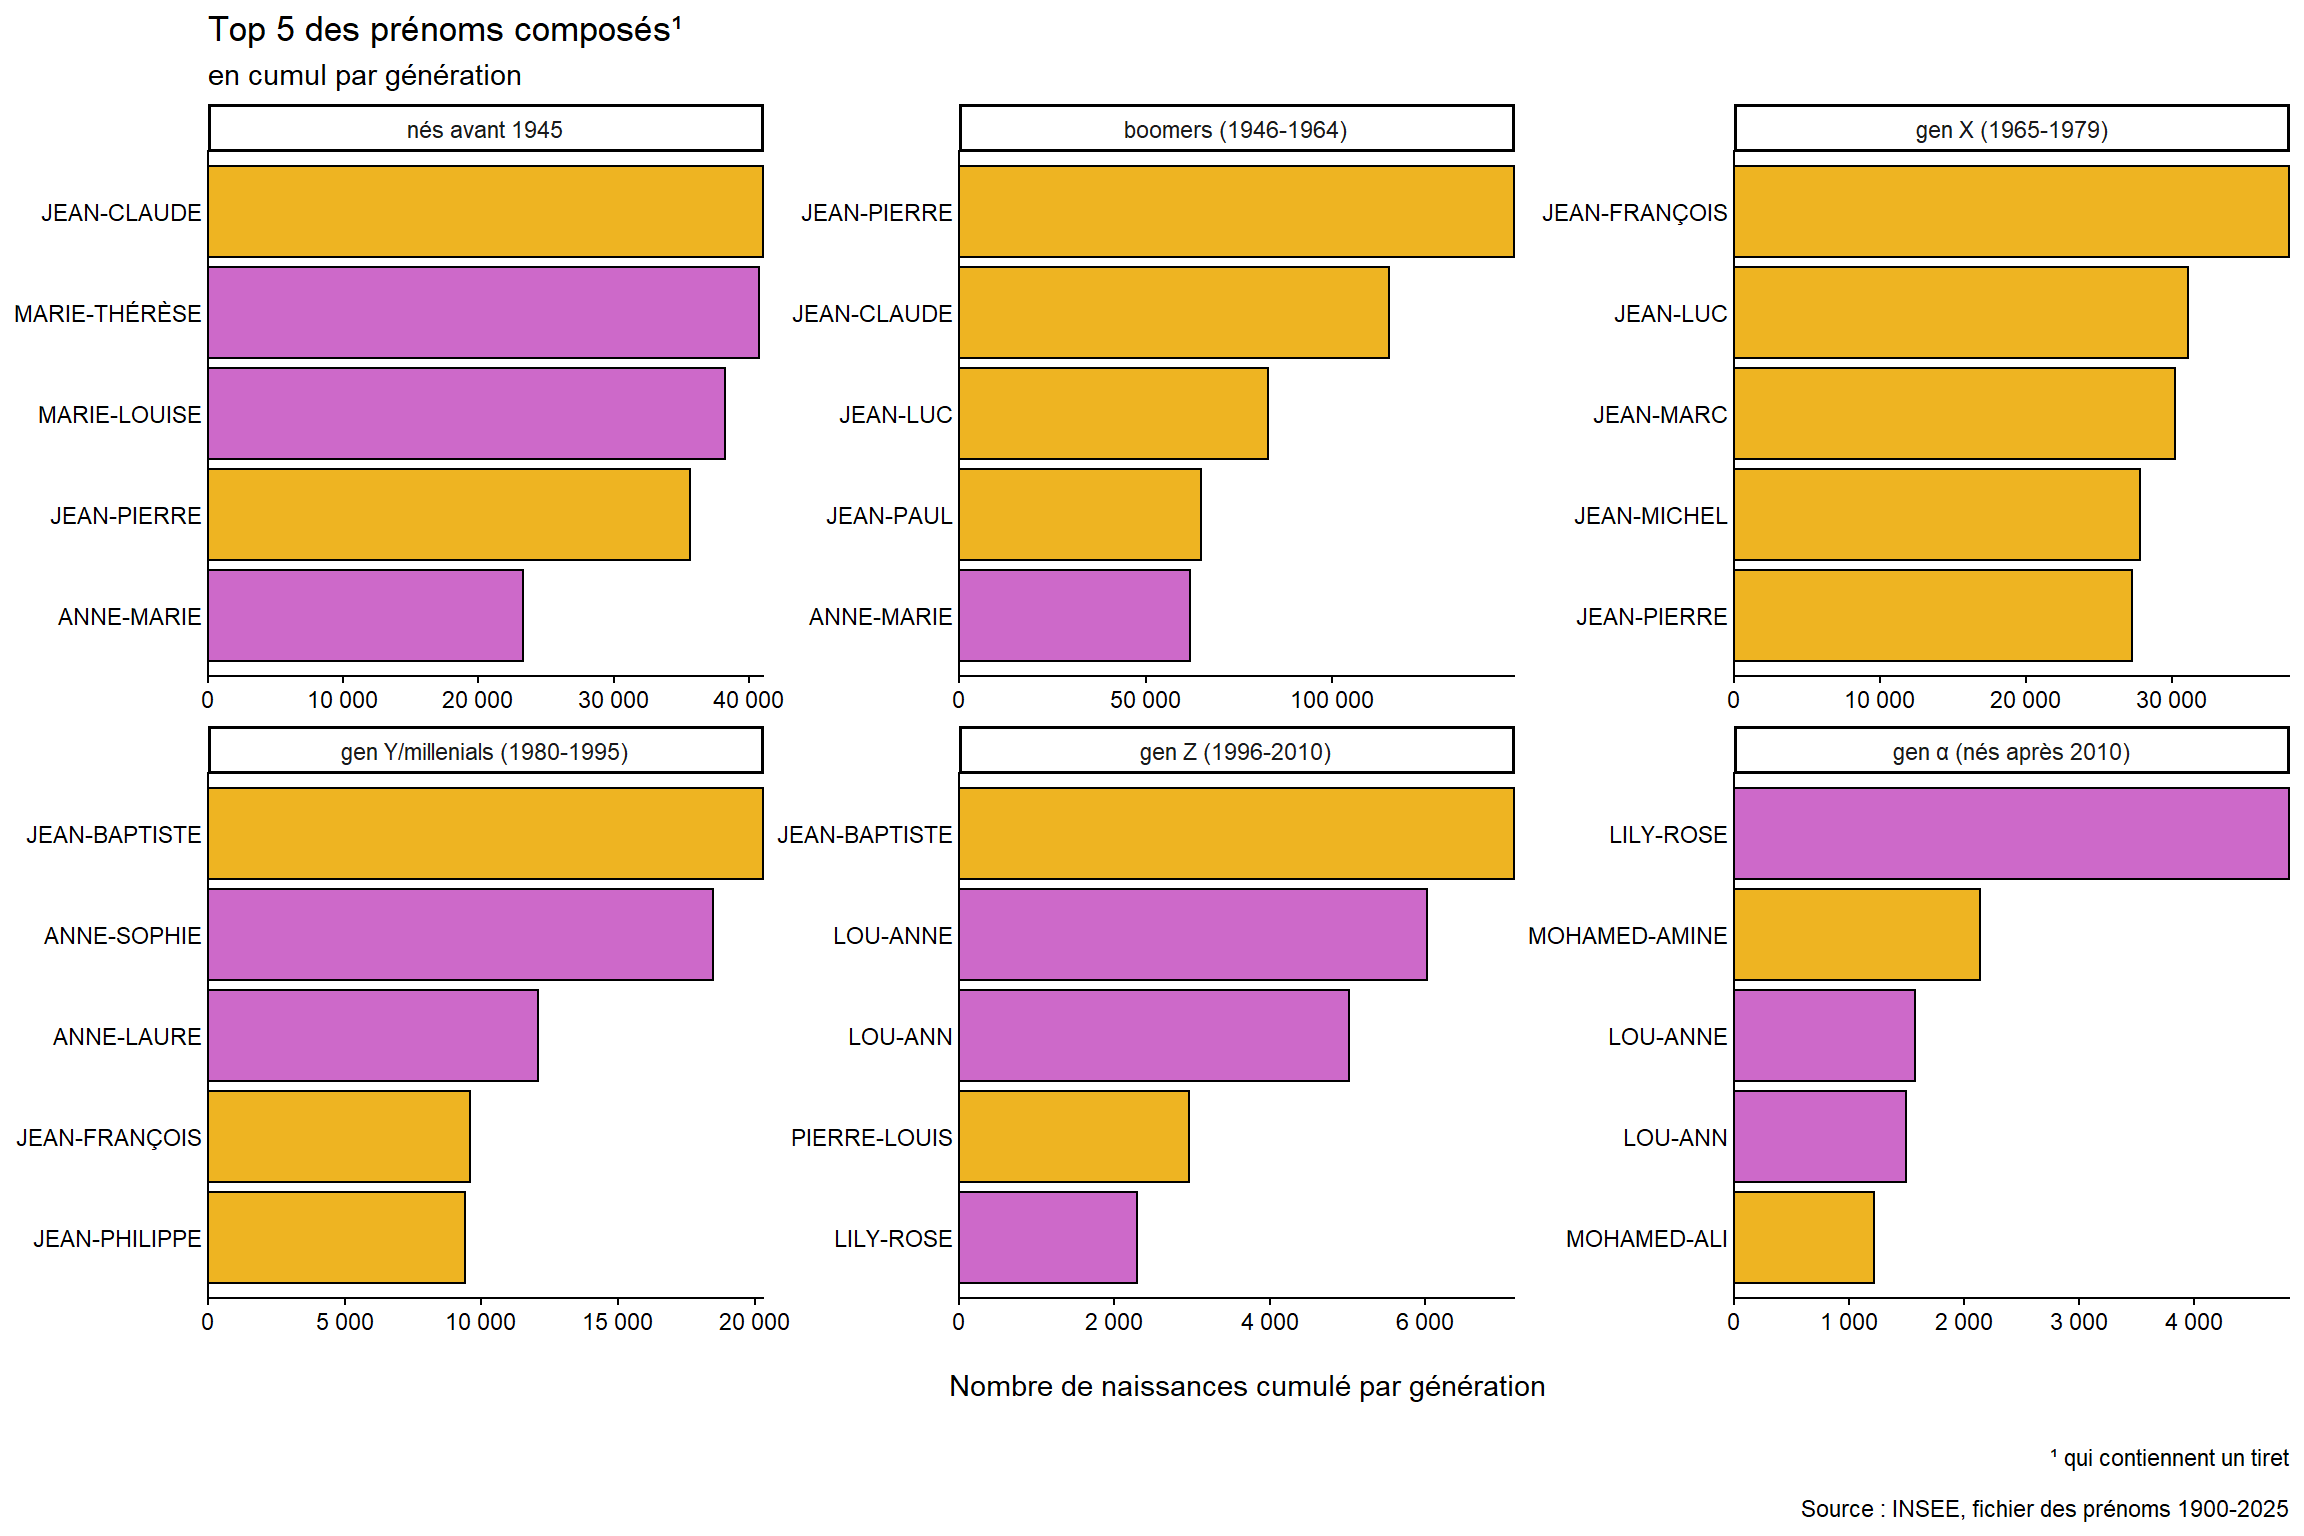
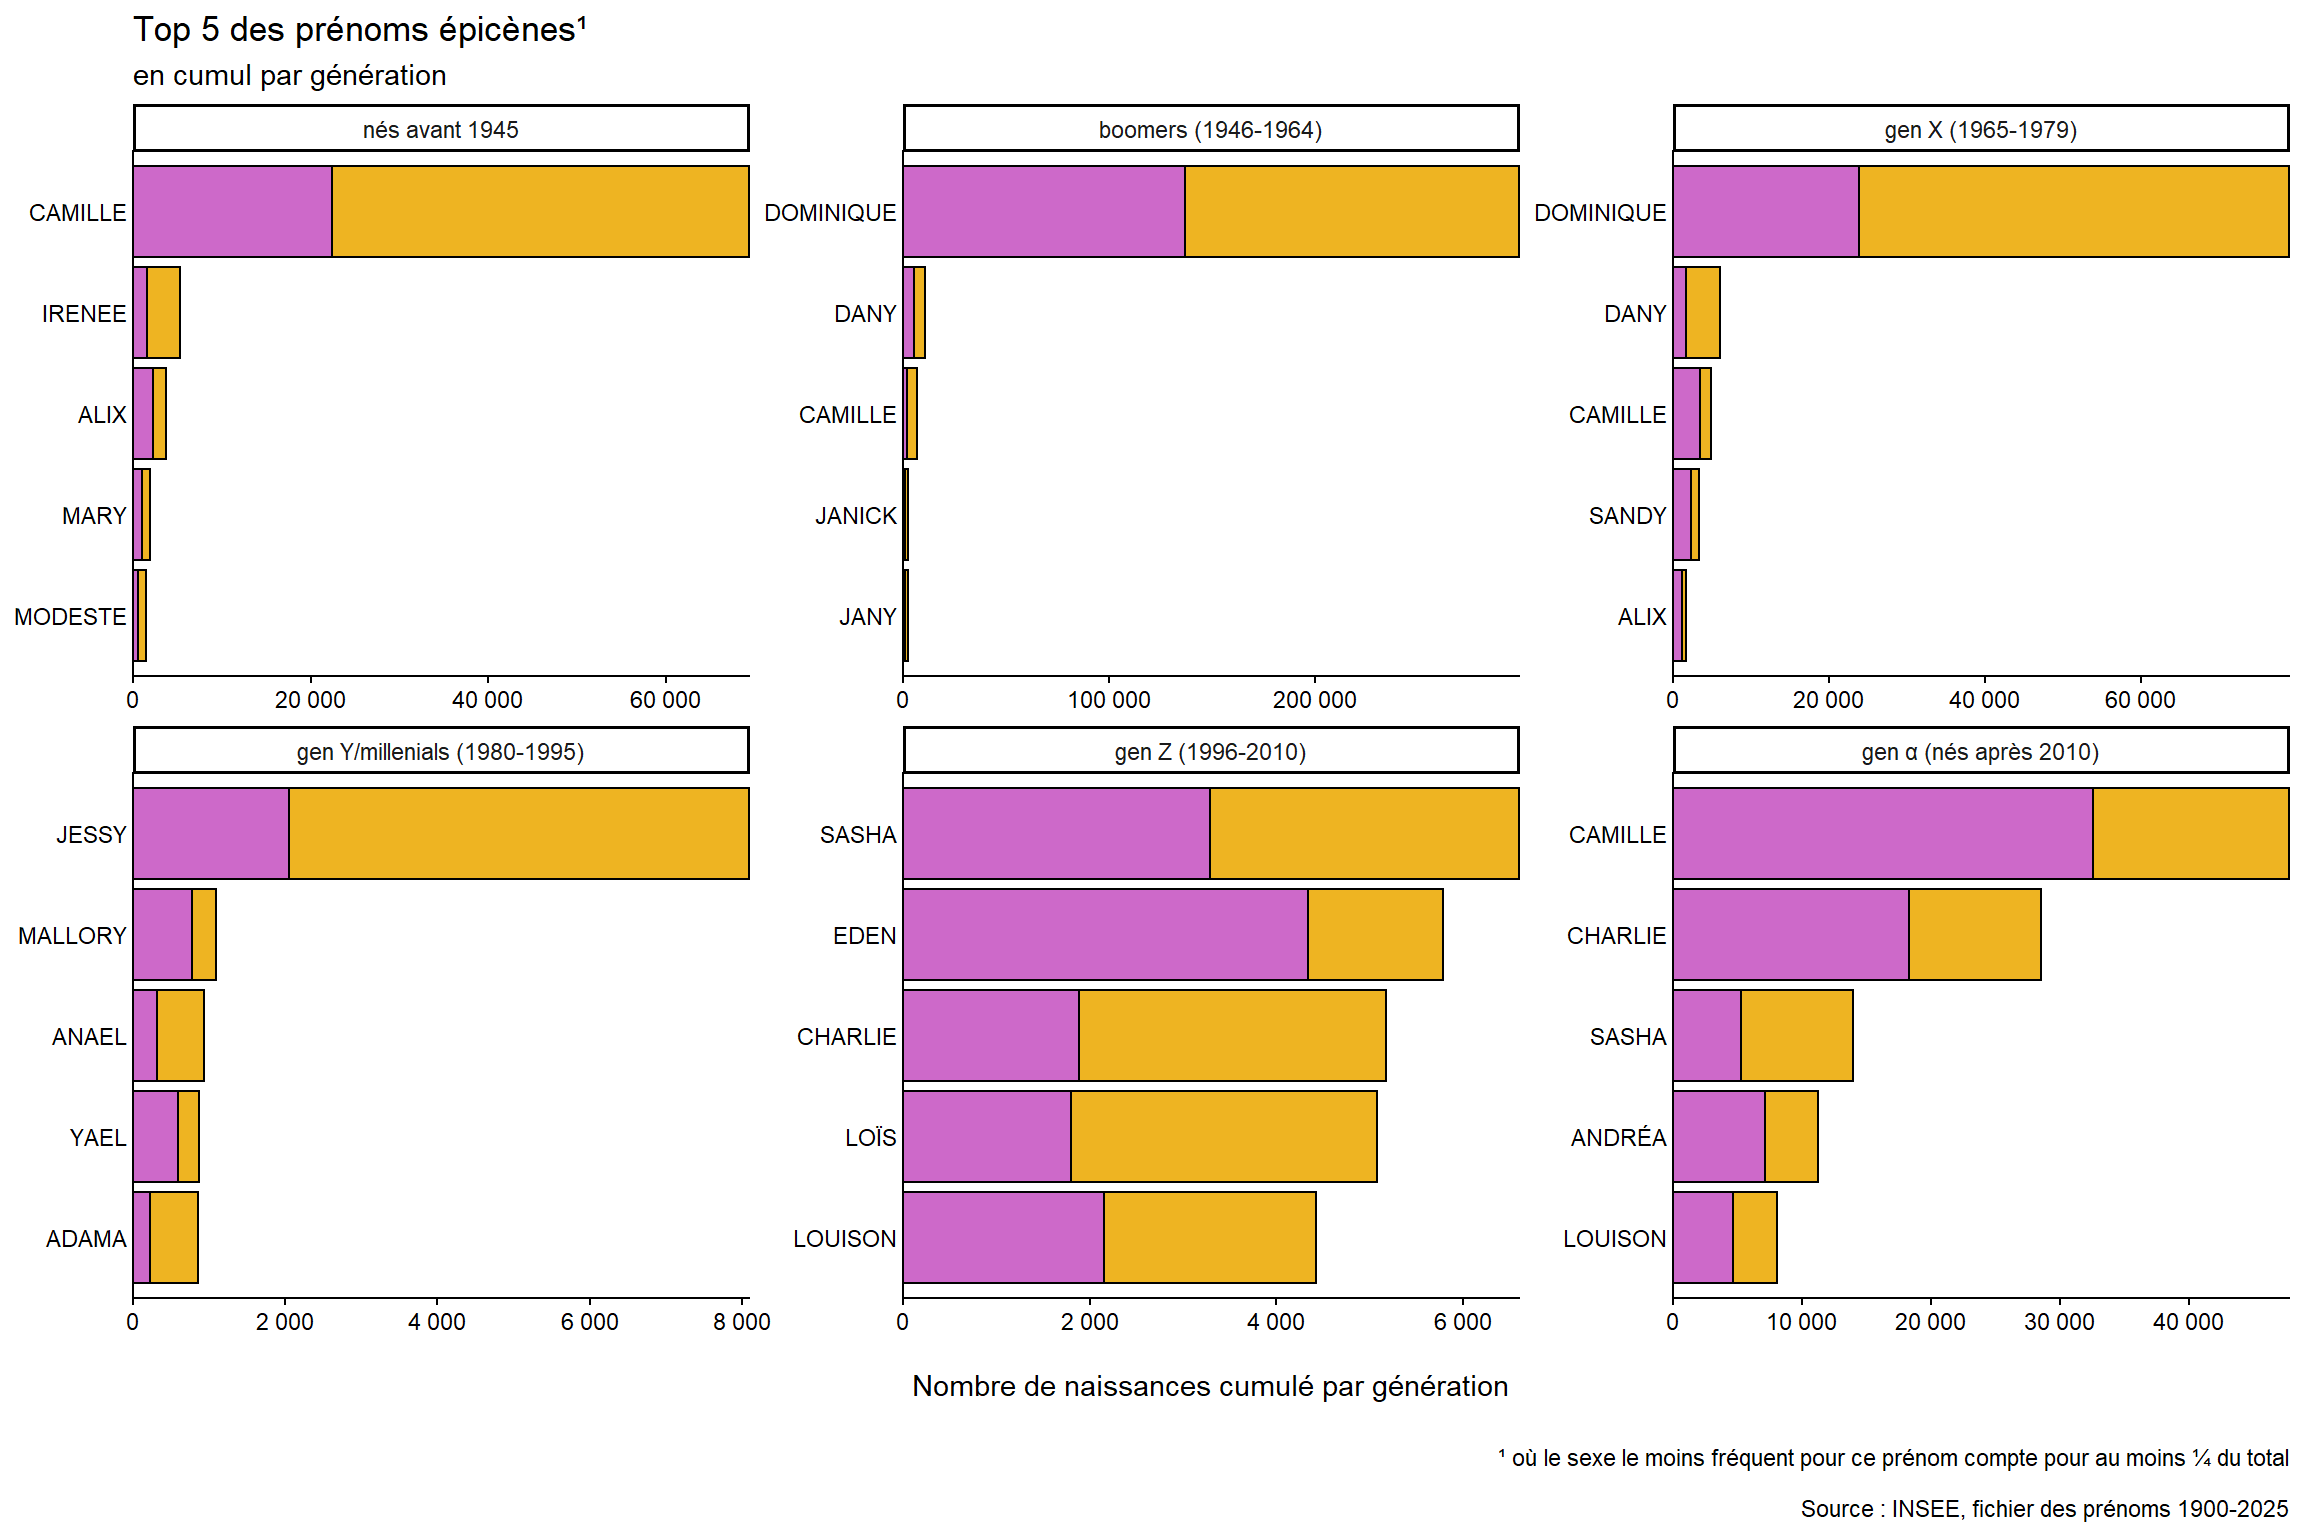
Le problème des graphiques précédents c’est qu’on y ressent souvent le poids des prénoms “classiques” (Jean et Marie sont les prénoms les plus donnés sur la première moitié du XXe siècle) et le poids démographique de la génération des baby-boomers. En découpant les données par périodes en fonction des générations (j’ai repris les définitions de Wikipedia) on peut espérer voir davantage de phénomènes.
cumuls <- tbl(bd, "pre_tbl") %>%
  filter(niveau_geographique == "FRANCE") %>%
  mutate(gen = case_when(
    as.integer(periode) < 1946                 ~ "nés avant 1945",
    as.integer(periode) %>% between(1946,1964) ~ "boomers (1946-1964)",
    as.integer(periode) %>% between(1965,1979) ~ "gen X (1965-1979)",
    as.integer(periode) %>% between(1980,1995) ~ "gen Y/millenials (1980-1995)",
    as.integer(periode) %>% between(1996,2010) ~ "gen Z (1996-2010)",
    as.integer(periode) > 2010                 ~ "gen \u3b1 (nés après 2010)"
  ) ) %>%
  group_by(gen, sexe, prenom) %>%
  summarise(tot = sum(valeur, na.rm = TRUE)) %>%
  ungroup() %>%
  collect() %>%
  mutate(gen = factor(gen,
                      levels=c("nés avant 1945",
                               "boomers (1946-1964)",
                               "gen X (1965-1979)",
                               "gen Y/millenials (1980-1995)",
                               "gen Z (1996-2010)",
                               "gen \u3b1 (nés après 2010)")))
`summarise()` has grouped output by "gen" and "sexe". You can override using
the `.groups` argument.
# filles
top5_gen_filles <- cumuls %>%
filter(sexe == "2") %>%
arrange(gen, desc(tot)) %>%
slice_head(n=5, by=gen)
# garçons
top5_gen_garcons <- cumuls %>%
filter(sexe == "1") %>%
arrange(gen, desc(tot)) %>%
slice_head(n=5, by=gen)
# prénoms épicènes (la proportion d'un sexe dans le total est entre 1/4 et 3/4)
top5_gen_epicene <- cumuls %>%
pivot_wider(id_cols = c(gen, prenom),
names_from = sexe,
names_prefix = "sexe_",
values_from = tot) %>%
mutate(tot = sexe_1 + sexe_2) %>%
filter(! is.na(tot)) %>%
filter( (sexe_1/tot) %>% between(0.25, 0.75)) %>%
arrange(gen, desc(tot)) %>%
slice_head(n=5, by=gen) %>%
select(- tot) %>%
pivot_longer(cols = -c(gen, prenom),
names_prefix = "sexe_",
names_to = "sexe",
values_to = "tot")
# prénoms composés (= contenant un tiret)
top5_gen_compose <- cumuls %>%
filter(grepl("-", prenom)) %>%
arrange(gen, desc(tot)) %>%
slice_head(n=5, by=gen)
# fonction pour produire les graphiques
top5_gen_plot <- function(data, titre=NULL, titre2=NULL, bdp=""){
ggplot(data) +
aes(y=reorder_within(prenom, tot, gen),
x=tot,
fill=sexe) +
geom_col(colour="black", show.legend = FALSE) +
theme_classic() +
scale_fill_manual(values=palette) +
scale_y_reordered() +
scale_x_continuous(labels = ~ prettyNum(.x, big.mark = " "),
expand = expansion(add=0)) +
labs(x = "\nNombre de naissances cumulé par génération\n",
y = NULL,
caption = paste(bdp,
"Source : INSEE, fichier des prénoms 1900-2025",
sep="\n\n"),
title = titre,
subtitle = titre2) +
theme(plot.title = element_markdown(),
plot.subtitle = element_markdown(),
axis.ticks.length.y = unit(0,"mm"))
}
Le fait de les présenter en facetting (= mosaïque de graphiques) avec une échelle horizontale commune pour certains montre aussi l’évolution des volumes de naissances au fil des générations.
L’échelle commune (scales="free_y" vs scales="free") n’a été proposée que pour les top 5 des filles et des garçons. Pour les prénoms composés et les prénoms épicènes, les variations de volume sont tellement énormes d’une génération à une autre que j’ai préféré laisser R faire librement ses axes des abscisses à chaque génération.
top5_gen_plot(data=top5_gen_filles ,
              titre="Top 5 des prénoms de <span style='color:orchid3'>filles</span>",
              titre2 = "en cumul par génération") +
  facet_wrap(vars(gen), scales="free_y")
top5_gen_plot(data=top5_gen_garcons,
              titre="Top 5 des prénoms de <span style='color:goldenrod2'>garçons</span>",
              titre2 = "en cumul par génération") +
  facet_wrap(vars(gen), scales="free_y")
top5_gen_plot(data=top5_gen_compose,
              titre="Top 5 des prénoms composés¹",
              titre2 = "en cumul par génération",
              bdp="¹ qui contiennent un tiret") +
  facet_wrap(vars(gen), scales="free")
top5_gen_plot(data=top5_gen_epicene,
              titre="Top 5 des prénoms épicènes¹",
              titre2 = "en cumul par génération",
              bdp="¹ où le sexe le moins fréquent pour ce prénom compte pour au moins ¼ du total") +
  facet_wrap(vars(gen), scales="free")
Prénoms spécifiques à une région
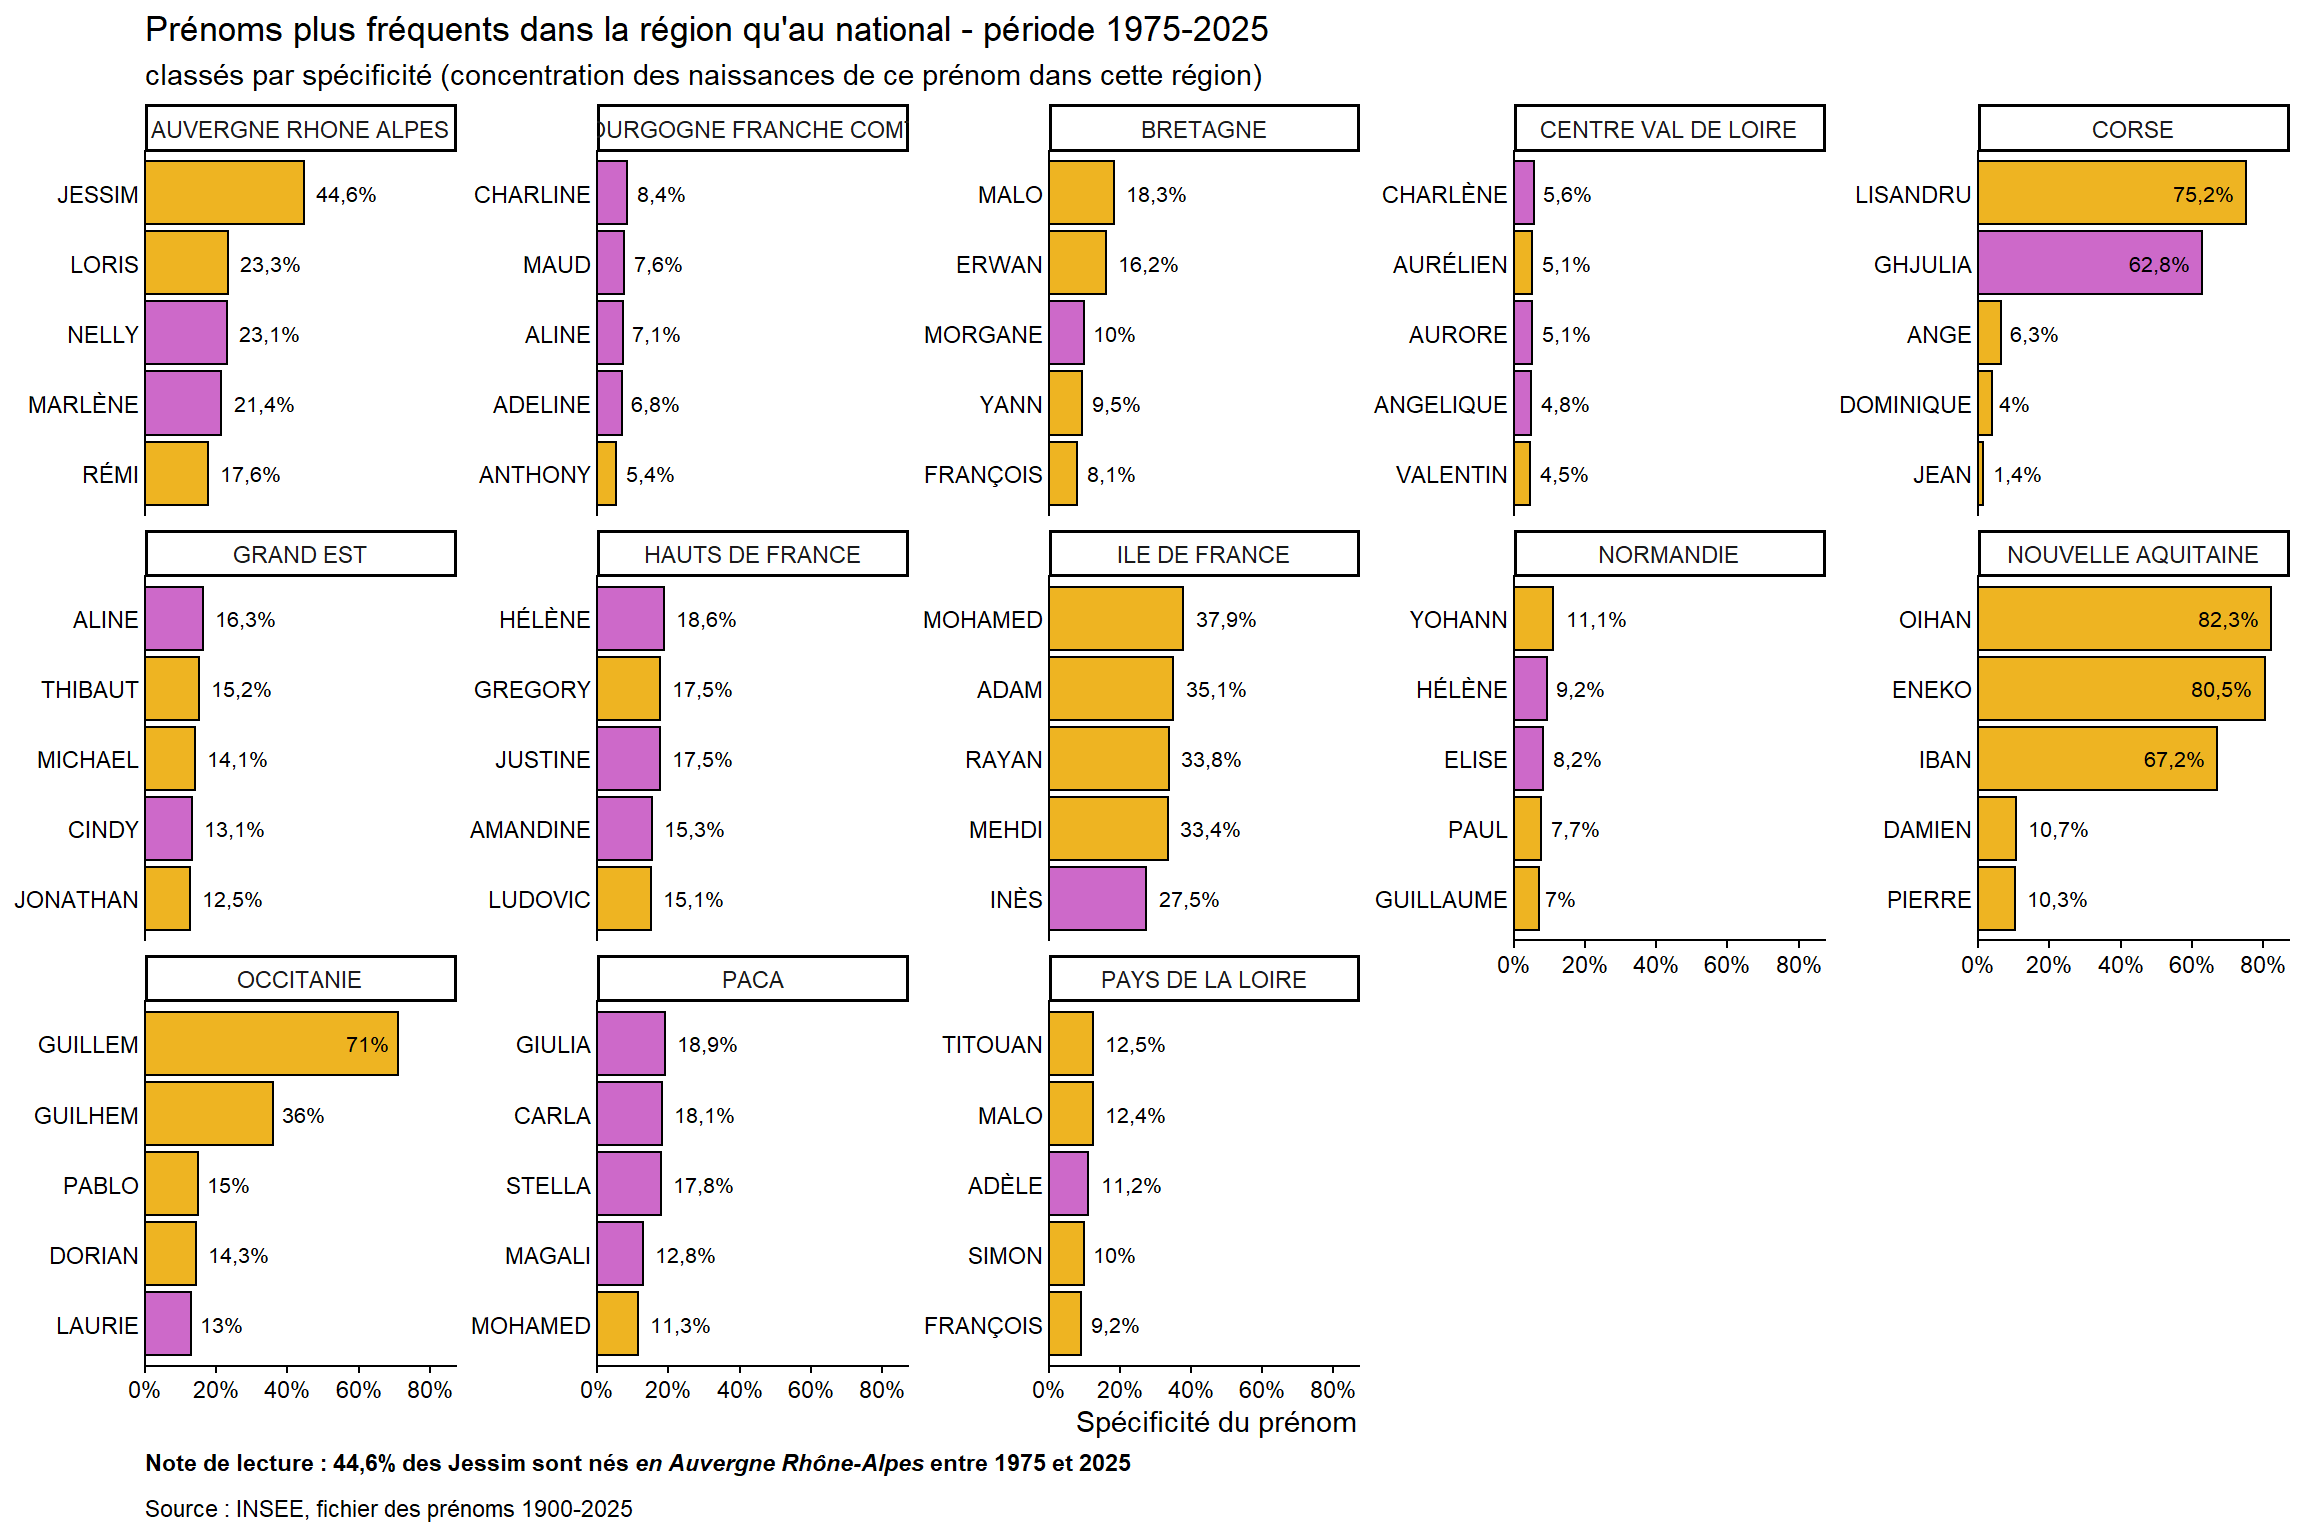
Dernier volet de mes analyses, j’ai voulu savoir s’il y avait des prénoms qu’on ne retrouvait quasiment que dans certaines régions. Pour cela, les statisticiens ne manquent pas d’outils, dont un que j’aime beaucoup (je l’ai découvert avec le logiciel Spad, je l’avais codé en macro SAS, je l’utilise désormais comme une fonction de {FactoMineR}) et dont l’utilisation initiale est de caractériser les classes à l’issue d’une segmentation type CAH ou K-means.
Pour faire court, il s’agit de tester la sur-représentation d’une modalité (ici, un couple prénom x sexe) dans une sous-catégorie (ici, une région) par rapport à sa distribution dans l’ensemble (ici, les naissances France entière). Si la sur-représentation est significative, cela veut dire qu’on a plus de chances de trouver ce prénom dans cette région qu’au global sans que ça puisse être dû au hasard. On peut visualiser le degré de sur-représentation par la spécificité du prénom, c’est à dire la part que représente cette région dans le total des naissances.
Par exemple, si le prénom X est donné 1000 fois, dont 400 en Pays de Loire, alors la spécificité de X est de 40% en Pays de Loire.
On imagine qu’un prénom “régional” aura des spécificités très élevées. Mais pas forcément des fréquences absolues très fortes (le prénom peut rester globalement rare car tout le monde, dans une région, n’a pas forcément envie de jouer la carte du régionalisme dans le choix des prénoms).
La période retenue est arbitrairement 1975-2025, pour n’étudier qu’une période où déroger aux saints du calendrier m’a semblé plus facile qu’au début du XXe siècle (je me trompe peut-être). Et uniquement les 13 régions de France métropolitaine parce que ça fait déjà beaucoup.
lib_reg <- c(
  "01" = "GUADELOUPE",
  "02" = "MARTINIQUE",
  "03" = "GUYANE",
  "04" = "LA REUNION",
  "06" = "MAYOTTE",
  "11" = "ILE DE FRANCE",
  "24" = "CENTRE VAL DE LOIRE",
  "27" = "BOURGOGNE FRANCHE COMTE",
  "28" = "NORMANDIE",
  "32" = "HAUTS DE FRANCE",
  "44" = "GRAND EST",
  "52" = "PAYS DE LA LOIRE",
  "53" = "BRETAGNE",
  "75" = "NOUVELLE AQUITAINE",
  "76" = "OCCITANIE",
  "84" = "AUVERGNE RHONE ALPES",
  "93" = "PACA",
  "94" = "CORSE"
)
reg <- tbl(bd, "pre_tbl") %>%
  filter(niveau_geographique=="REG") %>%
  filter(periode >= "1975") %>%
  group_by(geographie, prenom, sexe) %>%
  summarise(tot = sum(valeur, na.rm = TRUE)) %>%
  ungroup() %>%
  collect() %>%
  mutate(region = factor(geographie,
                         levels=names(lib_reg),
                         labels=lib_reg)) %>%
  arrange(region, desc(tot)) %>%
  mutate(prenom_sexe = paste(prenom, sexe, sep="@"))
`summarise()` has grouped output by "geographie" and "prenom". You can override
using the `.groups` argument.
# caractérisation
carac <- catdes(reg[,c("region", "prenom_sexe")],
num.var=1,
row.w = reg$tot)
# transformation du résultat de liste de matrices en data.frame
specif <- lapply(carac$category,
\(df){
df %>%
as.data.frame() %>%
mutate(prenom_sexe = gsub("prenom_sexe=","", rownames(.)))
}) %>% bind_rows(.id="region") %>%
arrange(region, desc(v.test), desc(`Mod/Cla`))
# garder les liste de prénoms et revenir aux fréquences observées
freq_reg <- left_join(specif,
reg,
by = join_by(region, prenom_sexe)) %>%
filter(tot > 250 &
! region %in% c("GUADELOUPE","MARTINIQUE",
"LA REUNION","MAYOTTE",
"GUYANE")) %>%
slice_head(n=5, by=region)
J’ai opté pour une mosaïque de 13 graphiques pour avoir des ordres de grandeur identiques. On pourrait tout aussi bien faire 13 graphiques séparés, ce sera plus lisible. Ou se limiter aux quelques régions (Bretagne, Corse, Nouvelle-Aquitaine) où on peut voir effectivement quelques choix typiquement locaux émerger.
ggplot(freq_reg) +
  aes(y=reorder_within(prenom, `Cla/Mod`, region),
      x=`Cla/Mod`, fill=sexe) +
  geom_col(colour="black", show.legend = FALSE) +
  geom_text(aes(label=paste0(
    prettyNum(
      janitor::round_half_up(`Cla/Mod`,1),
      decimal.mark = ","),
    "%"),
    hjust=ifelse(`Cla/Mod` > 60, 1.2, -0.2)),
    size=I(2.8)) +
  theme_classic() +
  scale_fill_manual(values=palette) +
  scale_y_reordered() +
  facet_wrap(vars(region), scales="free_y", ncol=5, nrow=3) +
  scale_x_continuous(labels = ~ scales::label_number(suffix = "%", decimal.mark = ",")(.x),
                     expand = expansion(add=c(0,5))) +
  labs(x = "Spécificité du prénom",
       y = NULL,
       caption = paste("**Note de lecture : 44,6% des Jessim sont nés *en Auvergne Rhône-Alpes* entre 1975 et 2025**",
                       "Source : INSEE, fichier des prénoms 1900-2025",
                       sep="\n\n"),
       title = "Prénoms plus fréquents dans la région qu'au national - période 1975-2025",
       subtitle = "classés par spécificité (concentration des naissances de ce prénom dans cette région)") +
  theme(axis.ticks.length.y = unit(0,"mm"),
        plot.caption = element_markdown(hjust=0))